6장. 평균 필터와 Gaussian 필터
실습 1 — 깨끗한 그림에 가우시안 노이즈 더하기
안내판 그림(ch06_board.png)에 씨앗을 고정한 가우시안 노이즈를 더하고, 노이즈 값이 정말 종 모양인지 히스토그램으로 확인합니다. 노이즈의 세기를 10, 20, 40 으로 바꿔 원본과 얼마나 달라지는지 숫자로 견줍니다.
1단계. 깨끗한 그림 읽기
import cv2
import numpy as np

# 지하 주차장 안내판을 흑백으로 읽는다. 연습용으로 도형과 글자를 그려 만든 가상의 그림이다
img = cv2.imread("ch06_board.png", cv2.IMREAD_GRAYSCALE)
print("모양:", img.shape, "/ 자료형:", img.dtype)

# 왼쪽 위 벽(세로 0~19, 가로 0~159)은 한 가지 밝기로 칠한 고른 면이다
wall = img[0:20, 0:160]
print("벽의 밝기 종류:", [int(v) for v in np.unique(wall)])
print("벽의 표준편차:", round(float(wall.std()), 2))모양: (240, 320) / 자료형: uint8
벽의 밝기 종류: [170]
벽의 표준편차: 0.02단계. 노이즈 표 만들기
# default_rng(600): 씨앗을 고정한 난수 만들개. 같은 씨앗이면 언제나 같은 노이즈가 나온다
rng = np.random.default_rng(600)
# normal(평균, 표준편차, 모양): 정규분포를 따르는 소수 난수를 그림과 같은 모양으로 만든다
noise = rng.normal(0, 20, img.shape)

print("노이즈 모양:", noise.shape)
print("앞의 다섯 값:", [round(float(v), 1) for v in noise[0, :5]])
print("평균:", round(float(noise.mean()), 2), "/ 표준편차:", round(float(noise.std()), 2))
print("가장 작은 값:", round(float(noise.min()), 1), "/ 가장 큰 값:", round(float(noise.max()), 1))

# np.abs: 절댓값. -20~20 안에 든 값과 -40~40 안에 든 값의 비율을 센다
print("-20~20 안의 비율:", round(float((np.abs(noise) < 20).mean()), 3))
print("-40~40 안의 비율:", round(float((np.abs(noise) < 40).mean()), 3))노이즈 모양: (240, 320)
앞의 다섯 값: [-8.3, -1.6, -14.8, -2.0, -32.7]
평균: -0.03 / 표준편차: 19.96
가장 작은 값: -87.0 / 가장 큰 값: 94.2
-20~20 안의 비율: 0.684
-40~40 안의 비율: 0.9553단계. 더하고 0~255 로 자르기
import matplotlib.pyplot as plt

# 그래프의 한글이 깨지지 않게 맑은 고딕을 쓰고, 빼기 기호가 네모로 나오지 않게 한다
plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# uint8 은 255 를 넘으면 0 으로 돌아가므로 소수(float64)로 바꿔 더한다
added = img.astype(np.float64) + noise
print("더한 값의 범위:", round(float(added.min()), 1), "~", round(float(added.max()), 1))
# np.clip(값, 아래, 위): 0 보다 작으면 0, 255 보다 크면 255 로 잘라 넣는다
noisy = np.clip(added, 0, 255).astype(np.uint8)
print("자른 뒤 범위:", int(noisy.min()), "~", int(noisy.max()))

# 벽의 같은 다섯 칸이 어떻게 흔들렸는지 본다
print("원본 벽 다섯 칸:", [int(v) for v in img[0, :5]])
print("노이즈 낀 다섯 칸:", [int(v) for v in noisy[0, :5]])

# 노이즈 값을 50개 구간으로 세어 막대그래프로 그린다. 종 모양인지 확인한다
fig, ax = plt.subplots(figsize=(7, 3))
ax.hist(noise.ravel(), bins=50)
ax.set_xlabel("노이즈 값")
ax.set_ylabel("칸 수")
ax.set_title("표준편차 20 인 노이즈 값의 히스토그램")
plt.tight_layout()
plt.show()더한 값의 범위: -45.3 ~ 303.9
자른 뒤 범위: 0 ~ 255
원본 벽 다섯 칸: [170, 170, 170, 170, 170]
노이즈 낀 다섯 칸: [161, 168, 155, 167, 137]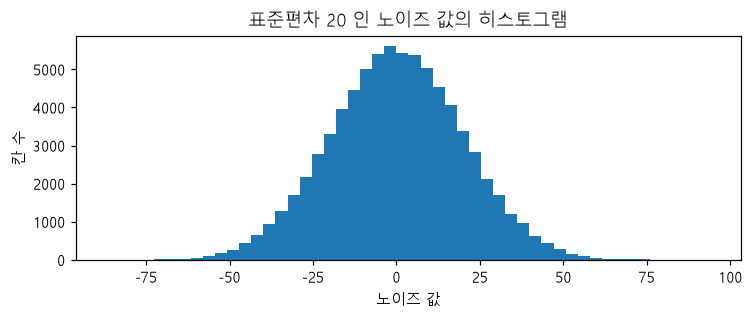
4단계. 노이즈 세기 견주기
def add_noise(image, sigma, seed=600):
    """평균 0, 표준편차 sigma 인 가우시안 노이즈를 더한다. 씨앗을 고정해 늘 같은 노이즈가 나온다."""
    rng = np.random.default_rng(seed)
    noise = rng.normal(0, sigma, image.shape)
    return np.clip(image.astype(np.float64) + noise, 0, 255).astype(np.uint8)

panels = [("원본", img)]
for sigma in (10, 20, 40):
    out = add_noise(img, sigma)
    # absdiff: absolute difference. 칸마다 |원본 - 결과| 를 구해 평균을 낸다
    mae = float(cv2.absdiff(out, img).mean())
    print(f"표준편차 {sigma:2}: 원본과의 평균 차이 {mae:.2f}")
    panels.append((f"표준편차 {sigma}", out))

fig, axes = plt.subplots(1, 4, figsize=(12, 2.8))
for ax, (title, arr) in zip(axes, panels):
    # 흑백이므로 cmap="gray", 밝기 기준을 0~255 로 고정한다
    ax.imshow(arr, cmap="gray", vmin=0, vmax=255)
    ax.set_title(title)
    ax.axis("off")
plt.tight_layout()
plt.show()표준편차 10: 원본과의 평균 차이 7.97
표준편차 20: 원본과의 평균 차이 15.81
표준편차 40: 원본과의 평균 차이 30.10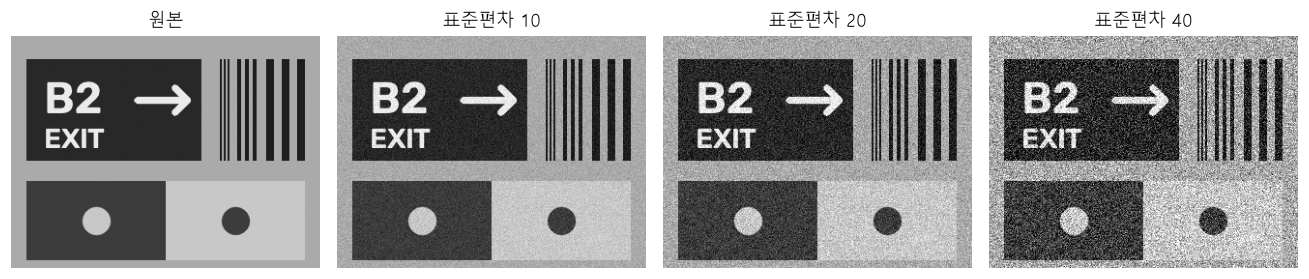
코드 설명
np.random.default_rng(600)은 씨앗 600 으로 난수 만들개를 만듭니다.rng.normal(0, 20, img.shape)는 평균 0, 표준편차 20 인 소수 난수를 그림과 같은 (240, 320) 모양으로 만듭니다. 평균은 -0.03, 표준편차는 19.96 으로 정한 값(0, 20)과 거의 같습니다. 가장 작은 값은 -87.0, 가장 큰 값은 94.2 로, 아주 드물게 크게 흔들리는 칸도 있습니다.- 노이즈 값의 0.684(68.4%)가 -20~20 안에, 0.955(95.5%)가 -40~40 안에 들어 있습니다. 대부분은 작고 아주 가끔 큰 흔들림이라는 뜻이고, 히스토그램도 0 에서 가장 높은 종 모양입니다.
- 원본에 노이즈를 더하면 -45.3 ~ 303.9 처럼 0~255 를 벗어난 값이 생깁니다.
np.clip으로 잘라야uint8로 안전하게 바꿀 수 있습니다. - 원본과의 평균 차이는 표준편차 10, 20, 40 에서 7.97, 15.81, 30.10 으로 노이즈 세기에 거의 비례해 커집니다. 표준편차보다 조금 작은 까닭은 정규분포에서 "차이의 크기의 평균"이 표준편차의 약 0.8배이기 때문입니다. 40 에서 0.75배로 조금 더 작은 것은 0~255 밖으로 나간 값을 잘라 냈기 때문입니다.