14장. 영상 기하학 변환과 Affine, Perspective
프로젝트 1 — 비스듬히 찍힌 문서 바로 펴고 크기 맞추기
강사가 수업에서 나눠 줄 안내문과 영수증 견본을 휴대폰으로 찍었습니다. 서둘러 찍느라 세 장 모두 비스듬하고, 문서마다 기운 정도가 다릅니다. 동료가 사진마다 네 귀퉁이 좌표를 적어 주었는데, 급하게 찍느라 순서가 뒤죽박죽입니다. 세 장을 바로 펴서 같은 크기(가로 180, 세로 240)로 맞추고, 한 줄로 이어 붙인 그림을 만들어 보세요. 바로 편 결과가 원래 문서와 얼마나 가까운지도 숫자로 재어 봅니다.
데이터는 ch14_docs/ 에 있습니다. 문서는 모두 영문과 숫자만 쓴 가상의 문서이고, 실제 상호와 개인정보는 없습니다. _flat 이 붙은 그림은 비스듬한 그림을 만들 때 쓴 바로 본 원본입니다.
| 파일 | 내용 |
|---|---|
notice.png, receipt_a.png, receipt_b.png | 책상 위에 비스듬히 놓인 문서를 찍은 가상의 그림 (320×240, 컬러) |
notice_flat.png, receipt_a_flat.png, receipt_b_flat.png | 같은 문서를 바로 본 원본 (180×240, 컬러) |
corners.json | 비스듬한 그림마다 문서의 네 귀퉁이 (x, y). 순서가 섞여 있다 |
요구사항
corners.json을 읽고, 그림마다 네 점을 왼쪽 위, 오른쪽 위, 오른쪽 아래, 왼쪽 아래 순서로 정렬해 찍습니다.- 세 장을 원근 변환으로 펴서 가로 180, 세로 240 으로 맞춥니다.
- 편 그림과
_flat원본의 평균 절대 차이(MAE)를 재고, 펴지 않고cv2.resize로 크기만 맞춘 그림의 MAE 와 함께 표로 찍습니다. 소수 둘째 자리까지 적습니다. - 위 줄에 비스듬한 원본, 아래 줄에 편 결과를 놓은 그림을 띄웁니다.
- 편 세 장을 가로로 이어 붙여
out_ch14_docs.png로 저장하고, 저장한 그림의 크기를 찍습니다.
힌트
json.load로 읽으면 파일 이름을 열쇠로, 네 점 목록을 값으로 하는 사전이 됩니다.- 네 점의 x + y 를 계산하면 왼쪽 위가 가장 작고 오른쪽 아래가 가장 큽니다. y − x 를 계산하면 오른쪽 위가 가장 작고 왼쪽 아래가 가장 큽니다.
argmin,argmax로 자리를 찾습니다. - 옮길 네 점은
[[0, 0], [179, 0], [179, 239], [0, 239]]입니다. 마지막 칸 번호는 크기보다 1 작습니다. - 높이가 같은 그림은
cv2.hconcat으로 가로로 이어 붙입니다. - 그림을 띄우는 격자는
plt.subplots(2, 3)로 만듭니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 점 정렬 | 섞인 네 점을 왼쪽 위부터 시계 방향으로 바르게 정렬한다 | 25 |
| 원근 변환 | 세 장을 180×240 으로 바르게 편다 | 25 |
| 숫자 비교 | 편 결과와 크기만 맞춘 결과의 MAE 를 표로 찍는다 | 20 |
| 비교 그림 | 비스듬한 원본과 편 결과를 2줄로 띄운다 | 15 |
| 저장 | 세 장을 이어 붙여 저장하고 크기를 찍는다 | 15 |
코드의 흐름
그림의 다섯 단계를 예시 풀이의 단계와 같은 순서로 짰습니다. 둘째 단계의 점 정렬이 이 프로젝트의 핵심입니다. 좌표를 사람이 찍든 12장의 윤곽선으로 찾든 순서는 뒤섞여 나오기 쉬우므로, 원근 변환 앞에 늘 정렬 함수를 둡니다.
실제 데이터로 해 보려면
실제 문서 사진으로 해 보려면 휴대폰으로 직접 찍은 사진과, 사진마다 네 귀퉁이를 눈금으로 읽어 적은 좌표 파일을 만들면 됩니다. 공개 데이터로 연습하려면 AI Hub(aihub.or.kr)처럼 문서·영수증 이미지를 공개한 곳에서 내려받습니다. 내려받기 전에 데이터마다 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 영수증과 문서에 이름, 전화번호, 카드 번호 같은 개인정보가 찍혀 있지 않은지, 있다면 개인정보 처리 기준을 먼저 확인합니다. 실제 사진은 귀퉁이가 손가락에 가리거나 종이가 휘어 있을 수 있어, 편 결과를 눈으로 한 번 확인해야 합니다.
결과 보기 (예시 풀이)
1단계. 좌표를 읽고 순서 맞추기
import json
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

folder = "ch14_docs"
# 요구사항 1: 파일 이름 → 네 점 (순서가 섞여 있다)
with open(f"{folder}/corners.json", encoding="utf-8") as f:
    corners = json.load(f)

def order_points(points):
    """네 점을 왼쪽 위, 오른쪽 위, 오른쪽 아래, 왼쪽 아래 순서로 정렬한다."""
    p = np.float32(points)
    s = p[:, 0] + p[:, 1]            # x + y: 왼쪽 위가 가장 작고, 오른쪽 아래가 가장 크다
    d = p[:, 1] - p[:, 0]            # y - x: 오른쪽 위가 가장 작고, 왼쪽 아래가 가장 크다
    return np.float32([p[s.argmin()], p[d.argmin()], p[s.argmax()], p[d.argmax()]])

ordered = {}
for name, points in corners.items():
    ordered[name] = order_points(points)
    print(f"{name:13} 받은 순서 {points}")
print(f"{'':13} 정렬한 순서 {ordered[name].astype(int).tolist()}")notice.png 받은 순서 [[222, 226], [88, 18], [70, 206], [236, 34]]
정렬한 순서 [[88, 18], [236, 34], [222, 226], [70, 206]]
receipt_a.png 받은 순서 [[222, 22], [66, 202], [80, 38], [238, 220]]
정렬한 순서 [[80, 38], [222, 22], [238, 220], [66, 202]]
receipt_b.png 받은 순서 [[62, 226], [262, 226], [214, 26], [110, 26]]
정렬한 순서 [[110, 26], [214, 26], [262, 226], [62, 226]]2단계. 원근 변환으로 펴고 MAE 재기
OUT_W, OUT_H = 180, 240
# 요구사항 2: 옮길 네 점, 마지막 칸 번호는 크기보다 1 작다
dst = np.float32([[0, 0], [OUT_W - 1, 0], [OUT_W - 1, OUT_H - 1], [0, OUT_H - 1]])

rows, photos, flats = [], {}, {}
for name, src in ordered.items():
    img = cv2.imread(f"{folder}/{name}")
    truth = cv2.imread(f"{folder}/{name.replace('.png', '_flat.png')}")
    # 원근 변환으로 편다
    P = cv2.getPerspectiveTransform(src, dst)
    flat = cv2.warpPerspective(img, P, (OUT_W, OUT_H))
    # 견줄 것: 펴지 않고 크기만 맞춘 그림
    resized = cv2.resize(img, (OUT_W, OUT_H), interpolation=cv2.INTER_AREA)
    photos[name], flats[name] = img, flat
    # 요구사항 3: 원래 문서와의 평균 절대 차이
    rows.append({"파일": name,
                 "편 결과 MAE": round(float(cv2.absdiff(flat, truth).mean()), 2),
                 "크기만 맞춘 MAE": round(float(cv2.absdiff(resized, truth).mean()), 2)})

table = pd.DataFrame(rows)
print(table.to_string(index=False)) 파일 편 결과 MAE 크기만 맞춘 MAE
notice.png 7.19 77.53
receipt_a.png 9.63 77.74
receipt_b.png 9.43 77.933단계. 비스듬한 원본과 편 결과 띄우기
# 요구사항 4: 위 줄은 비스듬한 원본, 아래 줄은 편 결과
fig, axes = plt.subplots(2, 3, figsize=(10, 7))
for k, name in enumerate(ordered):
    axes[0, k].imshow(cv2.cvtColor(photos[name], cv2.COLOR_BGR2RGB))
    # 정렬한 네 점을 선으로 이어 그려, 어느 사각형을 폈는지 보인다
    pts = np.vstack([ordered[name], ordered[name][:1]])
    axes[0, k].plot(pts[:, 0], pts[:, 1], linewidth=2)
    axes[0, k].set_title(name)
    axes[1, k].imshow(cv2.cvtColor(flats[name], cv2.COLOR_BGR2RGB))
    axes[1, k].set_title("편 결과 180×240")
for ax in axes.flat:
    ax.axis("off")
plt.tight_layout()
plt.show()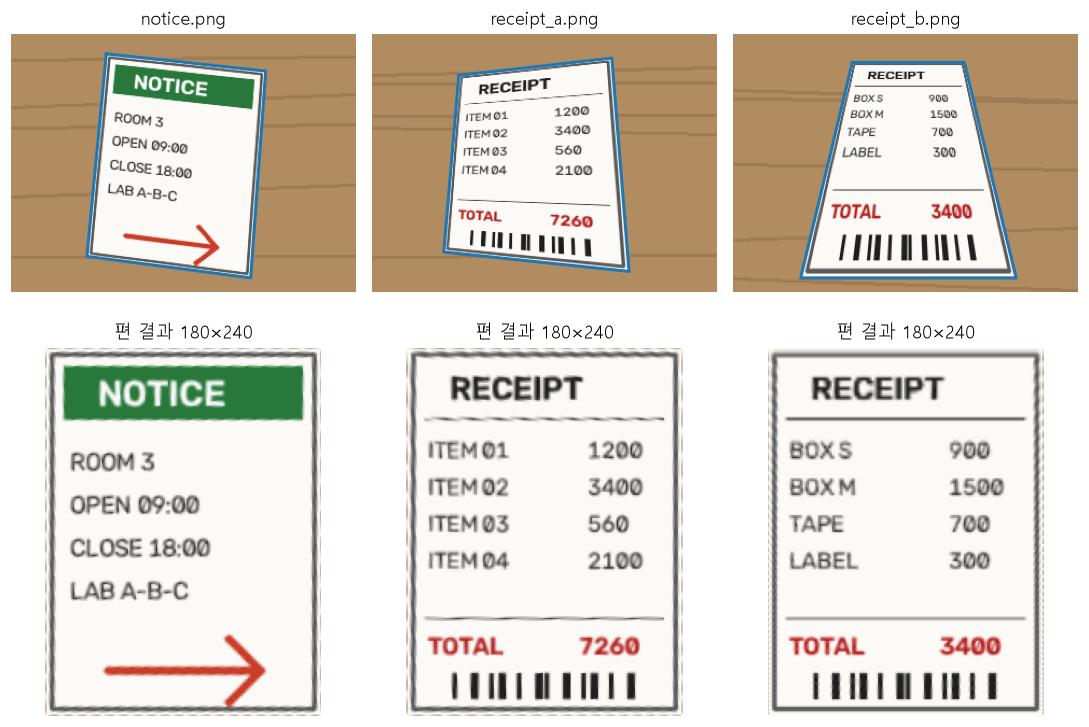
4단계. 이어 붙여 저장하기
# 요구사항 5: 높이가 모두 240 이므로 가로로 이어 붙일 수 있다
sheet = cv2.hconcat([flats[name] for name in ordered])
print("저장:", cv2.imwrite("out_ch14_docs.png", sheet))
print("저장한 그림 shape:", sheet.shape)

# 가장 많이 달라진 문서를 찾는다
worst = table.loc[table["편 결과 MAE"].idxmax()]
print(f"편 결과 MAE 가 가장 큰 문서: {worst['파일']} ({worst['편 결과 MAE']})")저장: True
저장한 그림 shape: (240, 540, 3)
편 결과 MAE 가 가장 큰 문서: receipt_a.png (9.63)order_points 는 섞여 있던 세 문서의 네 점을 모두 왼쪽 위부터 시계 방향으로 바르게 정렬했습니다. 예를 들어 notice.png 는 [222, 226] 이 먼저 적혀 있었지만, x + y 가 가장 큰 점이라 셋째(오른쪽 아래) 자리로 갔습니다. 편 결과와 바로 본 원본의 MAE 는 notice.png 7.19, receipt_a.png 9.63, receipt_b.png 9.43 이었습니다. 펴지 않고 크기만 맞춘 그림은 세 장 모두 77 을 넘어(77.53, 77.74, 77.93), 원근 변환으로 편 결과가 원본에 8배 이상 가깝습니다. 그래도 MAE 가 0 이 되지 않은 것은, 비스듬한 그림 속 문서가 180×240 보다 작게 찍혀 펴면서 키웠기 때문입니다. 아래 줄의 글자 가장자리가 원본보다 조금 흐린 것이 그 흔적입니다. MAE 가 가장 큰 문서는 receipt_a.png(9.63)였고, 세 장을 이어 붙인 out_ch14_docs.png 는 가로 540, 세로 240 입니다. 이렇게 크기를 맞춘 문서는 16장에서 데이터 증강의 재료로 쓸 수 있습니다.