17장. Batch Processing 과 YOLO 데이터 준비
실습 1 — 폴더 일괄 처리 기본
ch17_raw/ 의 그림 60장을 한꺼번에 처리합니다. 그림마다 크기와 평균 밝기를 표로 만들고, 흑백으로 바꿔 크기를 줄인 사본을 out_ch17_gray/ 에 저장하고, 처리 기록을 out_ch17_log.csv 로 남깁니다. 원본 폴더는 건드리지 않습니다.
1단계. 파일 목록 만들기
from pathlib import Path
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 원본 폴더. 실습은 data 폴더에서 실행하므로 상대 경로로 적는다
src = Path("ch17_raw")
# glob("*.png"): 이름이 .png 로 끝나는 파일을 찾는다. sorted: 이름순으로 줄 세운다
files = sorted(src.glob("*.png"))

print("그림 수:", len(files))
print("처음 세 장:", [p.name for p in files[:3]])
print("마지막 장:", files[-1].name)그림 수: 60
처음 세 장: ['part_001.png', 'part_002.png', 'part_003.png']
마지막 장: part_060.png2단계. 한 장 점검 함수를 만들어 모두 돌리기
import cv2
import pandas as pd

def inspect(path):
    """그림 한 장의 크기와 평균 밝기를 사전 하나로 돌려준다."""
    img = cv2.imread(str(path))                       # str(): Path 를 글자 경로로 바꿔 넘긴다
    h, w = img.shape[:2]
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)      # 밝기는 흑백으로 바꿔 잰다
    return {"파일": path.name, "가로": w, "세로": h, "밝기": round(float(gray.mean()), 1)}

# 먼저 한 장에 시험한다
print(inspect(files[0]))

# 함수를 모든 파일에 돌려 표로 만든다
table = pd.DataFrame([inspect(p) for p in files])
print("크기 종류:", table.groupby(["가로", "세로"]).size().to_dict())
print("밝기 요약:", table["밝기"].describe().round(1).to_dict())

# 평균 밝기가 50 보다 낮은 그림을 어두운 그림으로 골라 본다
dark = table[table["밝기"] < 50]
print("어두운 그림", len(dark), "장:", dark["파일"].tolist()){'파일': 'part_001.png', '가로': 320, '세로': 240, '밝기': 70.0}
크기 종류: {(320, 240): 60}
밝기 요약: {'count': 60.0, 'mean': 65.1, 'std': 14.7, 'min': 29.7, '25%': 67.3, '50%': 69.8, '75%': 72.8, 'max': 79.3}
어두운 그림 9 장: ['part_003.png', 'part_004.png', 'part_020.png', 'part_024.png', 'part_029.png', 'part_032.png', 'part_033.png', 'part_053.png', 'part_054.png']3단계. 흑백 사본을 만들고 기록 남기기
import time

out_dir = Path("out_ch17_gray")
# parents=True: 중간 폴더까지 만든다. exist_ok=True: 이미 있어도 오류를 내지 않는다
out_dir.mkdir(parents=True, exist_ok=True)

log = []
start = time.perf_counter()        # perf_counter: 걸린 시간을 재는 시계(초)
for k, path in enumerate(files, start=1):
    t0 = time.perf_counter()
    gray = cv2.imread(str(path), cv2.IMREAD_GRAYSCALE)
    # cv2.resize(그림, (가로, 세로)): 320x240 을 절반인 160x120 으로 줄인다
    small = cv2.resize(gray, (160, 120))
    target = out_dir / path.name                   # 같은 이름으로 결과 폴더에 쓴다
    ok = cv2.imwrite(str(target), small)
    log.append({"파일": path.name, "결과": "성공" if ok else "저장 실패",
                "저장": target.as_posix(), "ms": round((time.perf_counter() - t0) * 1000, 2)})
    if k % 20 == 0:                                # 20장마다 한 번 진행을 알린다
        print(f"[{k}/{len(files)}] 처리 중")

log_df = pd.DataFrame(log)
# utf-8-sig: 엑셀에서 열어도 한글이 깨지지 않는 저장 방식
log_df.to_csv("out_ch17_log.csv", index=False, encoding="utf-8-sig")
print("결과:", log_df["결과"].value_counts().to_dict())
print("저장한 사본:", len(list(out_dir.glob("*.png"))), "장 · 원본:", len(list(src.glob("*.png"))), "장")
print("전체 걸린 시간(초):", round(time.perf_counter() - start, 2))[20/60] 처리 중
[40/60] 처리 중
[60/60] 처리 중
결과: {'성공': 60}
저장한 사본: 60 장 · 원본: 60 장
전체 걸린 시간(초): 0.164단계. 사본 여덟 장을 한눈에 보기
# 저장한 사본을 다시 읽어 첫 여덟 장을 2x4 격자로 띄운다
saved = sorted(out_dir.glob("*.png"))[:8]
fig, axes = plt.subplots(2, 4, figsize=(10, 4), layout="constrained")
for ax, path in zip(axes.ravel(), saved):
    ax.imshow(cv2.imread(str(path), cv2.IMREAD_GRAYSCALE), cmap="gray", vmin=0, vmax=255)
    ax.set_title(path.name, fontsize=10)
    ax.axis("off")
fig.suptitle("out_ch17_gray 의 흑백 사본 (160x120)")
plt.show()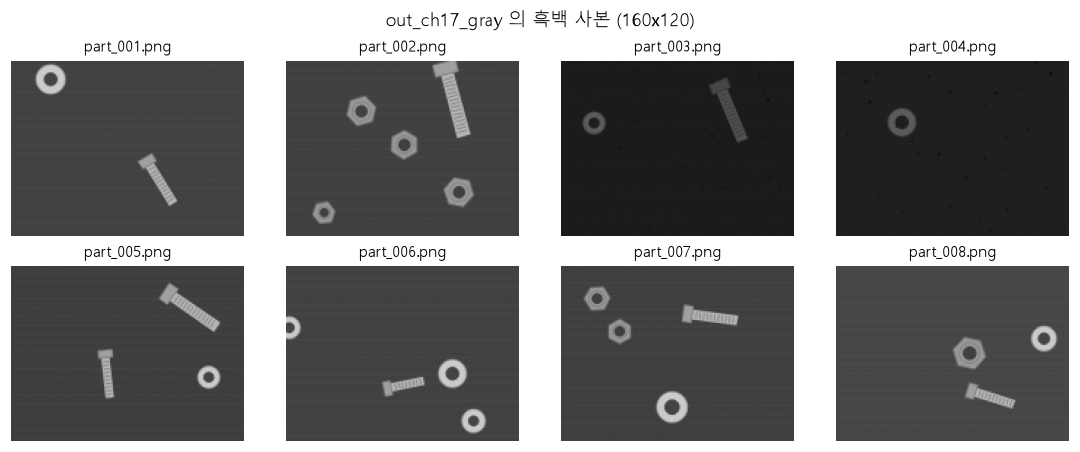
코드 설명
sorted(src.glob("*.png"))는 폴더의 png 를 이름순으로 줄 세운 목록입니다. 차례가 정해져야 기록과 결과를 다시 돌려도 같게 얻습니다.inspect처럼 한 장을 처리해 사전 하나를 돌려주는 함수를 만들면,pd.DataFrame([inspect(p) for p in files])한 줄로 표가 됩니다.out_dir.mkdir(parents=True, exist_ok=True)는 결과 폴더를 만들되, 이미 있으면 그냥 넘어갑니다. 결과는 원본과 다른 폴더에 쓰므로 원본은 그대로입니다.- 기록 표에는 파일마다 결과와 걸린 시간(ms, 1000분의 1초)을 적습니다. 걸린 시간은 컴퓨터마다 다릅니다.