17장. Batch Processing 과 YOLO 데이터 준비
프로젝트 1 — YOLO 데이터셋 점검 도구
부품 탐지 수업을 준비하는 강사라고 해 봅시다. 수강생들이 만든 YOLO 데이터셋을 받아 학습에 넣기 전에 점검해야 합니다. 폴더를 열어 하나하나 볼 수는 없으니, 폴더를 읽어 점검 보고서를 만드는 도구를 만듭니다. 클래스별로 물체가 몇 개인지, 학습용과 검증용의 클래스 비율이 비슷한지, 상자 크기가 어떻게 퍼져 있는지, 라벨에 범위 밖 값이나 짝 없는 파일이 없는지를 표와 그래프로 보이고, 무작위로 고른 그림에 라벨을 그려 저장합니다.
점검할 데이터는 실습 5에서 만든 out_ch17_yolo/ 입니다. 프로젝트는 처음부터 다시 실행되므로, 폴더가 없으면 실습 5를 먼저 실행하세요.
| 파일 | 내용 |
|---|---|
out_ch17_yolo/data.yaml | 데이터셋 자리와 클래스 이름(names) |
out_ch17_yolo/images/train, images/val | 학습용, 검증용 그림 (320×240 png, 가상 그림) |
out_ch17_yolo/labels/train, labels/val | 그림마다 같은 이름의 YOLO 라벨 .txt |
요구사항
data.yaml에서 클래스 이름을 읽고, 라벨 파일을 모두 읽어 한 줄에 물체 하나인 표(나눔, 파일, 클래스, xc, yc, w, h)를 만듭니다.- 점검표를 찍습니다. 짝 없는 그림, 짝 없는 라벨, 형식이 틀린 줄(숫자가 다섯 개가 아님), 모르는 클래스 번호, 범위 밖(상자의 왼쪽·오른쪽·위·아래 끝이 0~1 밖) 다섯 항목의 개수입니다.
- 클래스별 물체 수를 train, val 로 나눠 표로 찍고, 나눔마다 클래스 비율(%)을 함께 찍습니다.
- 그림당 물체 수의 분포와 상자 너비·높이(비율)의 요약을 찍습니다.
- 그래프 세 개를 한 그림에 그립니다. 클래스별 물체 수(train, val 막대), 그림당 물체 수, 상자 너비와 높이의 히스토그램입니다.
- 무작위로 고른 그림 여섯 장(씨앗 고정)에 라벨을 그려 2×3 격자로 붙여
out_ch17_check.png로 저장하고 띄웁니다. - 결론을 실제 숫자로 적습니다.
힌트
data.yaml은 줄마다 읽어" 0: bolt"처럼 생긴 줄에서 번호와 이름을 꺼내면 됩니다. PyYAML 이 없어도 됩니다.- 짝 검사는
images/train의 stem 집합과labels/train의 stem 집합을 빼서 구합니다. val 도 똑같이 합니다. - 상자의 왼쪽 끝은 xc − w ÷ 2, 오른쪽 끝은 xc + w ÷ 2 입니다. 소수 여섯째 자리에서 반올림한 값이라 0 보다 아주 조금 작을 수 있으니 0.000001 정도의 여유를 둡니다.
- 클래스 비율은
pd.crosstab(..., normalize="columns")로 나눔마다 합이 1 이 되게 구해 100 을 곱합니다. - 격자는 그림 여섯 장에 상자를 그린 뒤 2장에서 본
cv2.hconcat,cv2.vconcat으로 붙입니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 라벨 읽기 | data.yaml 의 이름과 모든 라벨을 표 하나로 모은다 | 15 |
| 점검표 | 다섯 항목을 빠짐없이 검사해 개수를 찍는다 | 25 |
| 클래스 표 | 나눔별 개수와 비율을 찍는다 | 15 |
| 분포 요약 | 그림당 물체 수와 상자 크기를 요약한다 | 10 |
| 그래프 | 세 그래프를 한 그림에 그린다 | 15 |
| 확인 격자 | 씨앗을 고정해 고른 여섯 장에 라벨을 그려 저장한다 | 10 |
| 결론 | 실제 숫자로 적는다 | 10 |
코드의 흐름
그림의 다섯 단계를 예시 풀이의 단계와 같은 순서로 짰습니다. 첫째 단계에서 라벨을 표 하나로 모아 두면 둘째부터 넷째 단계는 그 표를 세고 그리기만 하면 됩니다. 다섯째 단계의 격자는 숫자 점검이 놓치는 실수(엉뚱한 물체에 그린 상자)를 눈으로 찾기 위한 것입니다.
실제 데이터로 해 보려면
실제 사진으로 해 보려면 AI Hub(aihub.or.kr)에서 제조 부품이나 물류 물품처럼 상자 주석이 함께 있는 이미지 자료를 찾아 내려받습니다. 내려받기 전에 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 사람이 찍힌 사진은 얼굴과 개인정보가 드러나지 않게 다룹니다. 공개 자료의 주석은 Pascal VOC 의 XML 이나 COCO 의 JSON 처럼 형식이 제각각이므로, 실습 3의 함수로 YOLO 형식으로 바꾼 뒤 이 점검 도구를 돌립니다. 그림 크기가 제각각이면 라벨을 바꿀 때 그림마다 크기를 읽어 나눕니다.
결과 보기 (예시 풀이)
1단계. 라벨을 표 하나로 모으기
from pathlib import Path
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

root = Path("out_ch17_yolo")
if not (root / "data.yaml").exists():
    raise SystemExit("out_ch17_yolo 가 없습니다. 실습 5를 먼저 실행하세요")

# data.yaml 에서 "  0: bolt" 꼴의 줄만 골라 번호와 이름을 꺼낸다
names = {}
for line in (root / "data.yaml").read_text(encoding="utf-8").split("\n"):
    key, _, value = line.strip().partition(": ")      # partition: 첫 ": " 에서 앞, 가운데, 뒤로 나눈다
    if key.isdigit():
        names[int(key)] = value
print("클래스:", names)

rows, bad_lines = [], []
for part in ("train", "val"):
    for txt in sorted((root / "labels" / part).glob("*.txt")):
        for no, line in enumerate(txt.read_text(encoding="utf-8").split("\n"), start=1):
            if not line.strip():
                continue
            parts = line.split()
            if len(parts) != 5:                          # 형식 검사: 숫자가 다섯 개여야 한다
                bad_lines.append((txt.name, no))
                continue
            cls, xc, yc, w, h = int(parts[0]), *[float(v) for v in parts[1:]]
            rows.append({"split": part, "file": txt.stem, "cls": cls, "xc": xc, "yc": yc, "w": w, "h": h})

labels = pd.DataFrame(rows)
labels["name"] = labels["cls"].map(names)
print("물체:", len(labels), "개 · 라벨 파일:", labels["file"].nunique(), "개")
print(labels.head(3).to_string(index=False))클래스: {0: 'bolt', 1: 'nut', 2: 'washer'}
물체: 172 개 · 라벨 파일: 56 개
split file cls xc yc w h name
train part_002 1 0.506250 0.481250 0.11250 0.170833 nut
train part_002 1 0.740625 0.752083 0.13125 0.170833 nut
train part_002 0 0.709375 0.220833 0.16250 0.441667 bolt2단계. 점검표 만들기
EPS = 0.000001                                         # 소수 여섯째 자리 반올림 여유
check = {}
for part in ("train", "val"):
    img_stems = {p.stem for p in (root / "images" / part).glob("*.png")}
    lab_stems = {p.stem for p in (root / "labels" / part).glob("*.txt")}
    check[f"짝 없는 그림({part})"] = len(img_stems - lab_stems)
    check[f"짝 없는 라벨({part})"] = len(lab_stems - img_stems)
check["형식이 틀린 줄"] = len(bad_lines)
check["모르는 클래스 번호"] = int((~labels["cls"].isin(names)).sum())
left, right = labels["xc"] - labels["w"] / 2, labels["xc"] + labels["w"] / 2
top, bottom = labels["yc"] - labels["h"] / 2, labels["yc"] + labels["h"] / 2
outside = (left < -EPS) | (top < -EPS) | (right > 1 + EPS) | (bottom > 1 + EPS)
check["범위 밖 상자"] = int(outside.sum())

report = pd.DataFrame({"항목": list(check), "문제 수": list(check.values())})
print(report.to_string(index=False))
print("판정:", "통과" if report["문제 수"].sum() == 0 else "확인 필요") 항목 문제 수
짝 없는 그림(train) 0
짝 없는 라벨(train) 0
짝 없는 그림(val) 0
짝 없는 라벨(val) 0
형식이 틀린 줄 0
모르는 클래스 번호 0
범위 밖 상자 0
판정: 통과3단계. 클래스 표와 분포 요약
counts = pd.crosstab(labels["name"], labels["split"])
ratio = (pd.crosstab(labels["name"], labels["split"], normalize="columns") * 100).round(1)
table = pd.concat([counts, ratio.add_suffix("_%")], axis=1)   # 개수 열 옆에 비율 열을 붙인다(add_suffix: 열 이름 뒤에 _% 를 붙인다)
print(table)

# 그림당 물체 수: 파일마다 줄 수를 센 뒤, 그 수가 몇 번 나오는지 센다
per_image = labels.groupby(["split", "file"]).size()
print("그림당 물체 수:", per_image.value_counts().sort_index().to_dict())
print("그림당 평균:", round(float(per_image.mean()), 2), "개")

# 상자 너비와 높이(그림 크기에 대한 비율)의 요약
print(labels[["w", "h"]].describe().loc[["min", "mean", "max"]].round(3))split train val train_% val_%
name
bolt 41 7 28.1 26.9
nut 49 10 33.6 38.5
washer 56 9 38.4 34.6
그림당 물체 수: {1: 9, 2: 11, 3: 13, 4: 13, 5: 10}
그림당 평균: 3.07 개
w h
min 0.062 0.067
mean 0.132 0.169
max 0.328 0.4424단계. 그래프 세 개
fig, axes = plt.subplots(1, 3, figsize=(13, 3.8), layout="constrained")

# (1) 클래스별 물체 수: train 과 val 막대를 나란히
x = np.arange(len(counts))
axes[0].bar(x - 0.2, counts["train"], width=0.4, label="train")
axes[0].bar(x + 0.2, counts["val"], width=0.4, label="val")
axes[0].set_xticks(x, labels=counts.index)
axes[0].set_title("클래스별 물체 수")
axes[0].legend()

# (2) 그림당 물체 수: 1개짜리 그림이 몇 장, 2개짜리가 몇 장…
dist = per_image.value_counts().sort_index()
axes[1].bar(dist.index, dist.values)
axes[1].set_xlabel("그림 한 장의 물체 수")
axes[1].set_ylabel("그림 수")
axes[1].set_title("그림당 물체 수")

# (3) 상자 너비와 높이(비율)의 히스토그램
bins = np.linspace(0, 0.45, 19)                  # 0~0.45 를 0.025 간격 18칸으로
axes[2].hist(labels["w"], bins=bins, alpha=0.6, label="너비 w")
axes[2].hist(labels["h"], bins=bins, alpha=0.6, label="높이 h")
axes[2].set_xlabel("그림 크기에 대한 비율")
axes[2].set_title("상자 크기 분포")
axes[2].legend()
plt.show()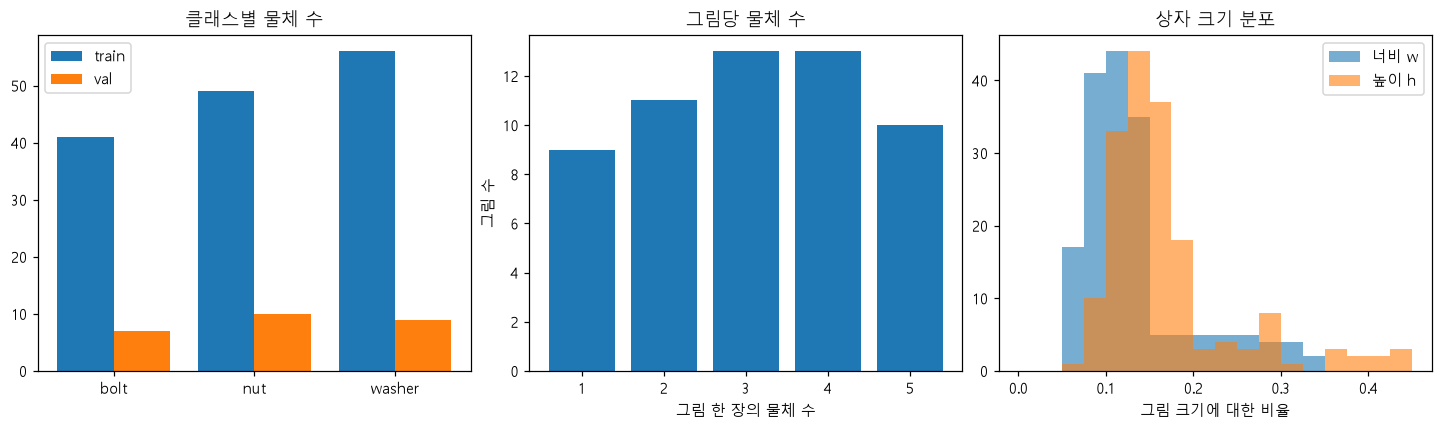
5단계. 무작위 여섯 장의 확인 격자
rng = np.random.default_rng(1718)                      # 씨앗을 고정해 늘 같은 여섯 장을 고른다
all_images = sorted((root / "images").rglob("*.png"))
picked = [all_images[i] for i in sorted(rng.choice(len(all_images), 6, replace=False))]
colors = {0: (0, 0, 255), 1: (0, 200, 255), 2: (255, 200, 0)}   # BGR

tiles = []
for p in picked:
    img = cv2.imread(str(p))
    h, w = img.shape[:2]
    part = p.parent.name                               # 그림이 든 폴더 이름(train 또는 val)
    for r in labels[(labels["split"] == part) & (labels["file"] == p.stem)].itertuples():
        x1, y1 = round((r.xc - r.w / 2) * w), round((r.yc - r.h / 2) * h)
        x2, y2 = round((r.xc + r.w / 2) * w), round((r.yc + r.h / 2) * h)
        cv2.rectangle(img, (x1, y1), (x2, y2), colors[r.cls], 2)
        cv2.putText(img, names[r.cls], (x1, max(y1 - 4, 12)), cv2.FONT_HERSHEY_SIMPLEX, 0.45, colors[r.cls], 1)
    cv2.putText(img, f"{part}/{p.name}", (6, 232), cv2.FONT_HERSHEY_SIMPLEX, 0.45, (255, 255, 255), 1)
    tiles.append(img)

sheet = cv2.vconcat([cv2.hconcat(tiles[:3]), cv2.hconcat(tiles[3:])])
print("격자 모양:", sheet.shape, "· 저장:", cv2.imwrite("out_ch17_check.png", sheet))
print("고른 그림:", [f"{p.parent.name}/{p.name}" for p in picked])

plt.figure(figsize=(11, 5.6))
plt.imshow(cv2.cvtColor(sheet, cv2.COLOR_BGR2RGB))
plt.title("무작위로 고른 여섯 장의 라벨 확인 (out_ch17_check.png)")
plt.axis("off")
plt.show()격자 모양: (480, 960, 3) · 저장: True
고른 그림: ['train/part_012.png', 'train/part_039.png', 'train/part_048.png', 'train/part_050.png', 'val/part_034.png', 'val/part_049.png']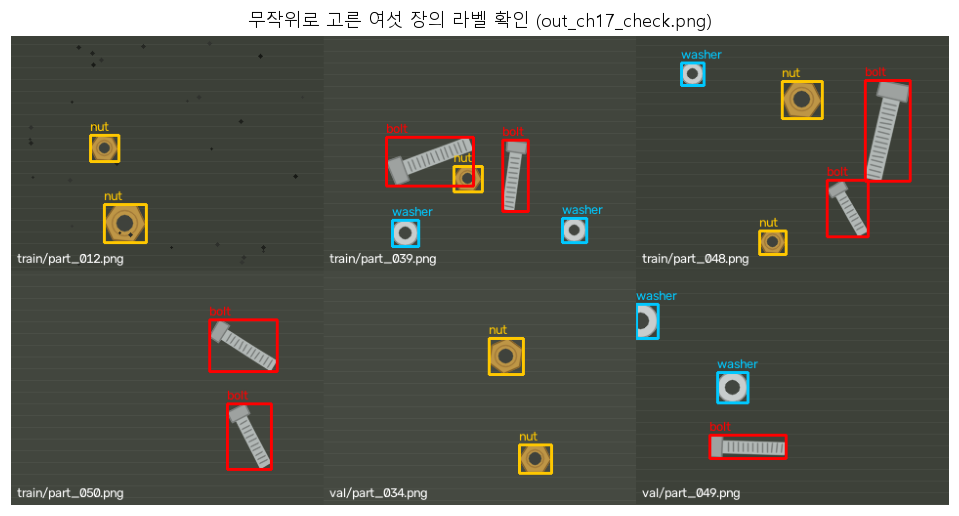
점검표의 다섯 항목은 모두 문제 0 으로 통과했습니다. 데이터셋에는 그림 56장(train 45장, val 11장)에 물체 172개(train 146개, val 26개)가 있고, 클래스별로는 bolt 48개, nut 59개, washer 65개로 볼트가 조금 적습니다. 클래스 비율은 train 이 bolt 28.1%, nut 33.6%, washer 38.4%, val 이 26.9%, 38.5%, 34.6% 입니다. nut 과 washer 에서 4~5%p 쯤 차이가 나는 것은 val 이 물체 26개뿐이라 물체 한두 개로도 비율이 몇 %씩 흔들리기 때문입니다. 그림당 물체 수는 1개부터 5개까지 9~13장씩 고르게 퍼져 평균 3.07개입니다. 상자 너비는 그림 가로의 0.062~0.328, 높이는 세로의 0.067~0.442 이고, 너비나 높이가 0.2 를 넘는 상자 43개는 모두 길쭉한 볼트입니다. 확인 격자의 여섯 장에서도 상자가 부품에 맞게 그려졌습니다. 이 데이터셋은 18장에서 그대로 학습에 씁니다. 실제 수업에서는 val 의 물체 수를 늘리거나 클래스 비율이 비슷해지게 나누면 검증 결과를 더 믿을 수 있습니다.