11장. Canny 와 Edge 비교
프로젝트 1 — 경계 검출 알고리즘 비교 보고서
강사가 "경계 검출" 수업을 준비하며, 수강생에게 "어떤 알고리즘을 언제 쓰나"를 숫자로 보여 주려고 합니다. 정답 경계가 있는 가상의 그림 세 장(도형, 부품, 글자)에 노이즈를 세 단계로 더해 가며 Sobel + 임계값, Laplacian + 임계값, Canny 를 돌리고, 정밀도·재현율·F1 과 걸린 시간을 표로 견줘 추천할 방법을 골라 보세요.
데이터는 ch11_set/ 에 있습니다. 그림을 그리면서 같은 도형의 테두리를 정답 경계로 함께 저장했습니다. 글자 그림의 영문 문구는 지어낸 것입니다.
| 파일 | 내용 |
|---|---|
shapes.png | 원, 네모, 세모, 타원이 놓인 도형 그림 (320×240, 흑백). 오른쪽 아래 네모는 바탕과 밝기 차이가 작다 |
parts.png | 톱니바퀴, 와셔, 볼트가 놓인 부품 그림 |
letters.png | 어두운 바탕에 밝은 영문 글자 "EDGE", "Canny 11" 을 쓴 그림 |
이름_edge.png | 그 그림의 정답 경계. 경계 칸 255, 나머지 0, 두께 1 |
요구사항
- 세 그림과 정답 경계를 흑백으로 읽고, 그림마다 정답 경계 칸의 비율을 찍습니다.
- 노이즈는 6장에서 쓴 것과 같은 꼴로, 표준편차 0(노이즈 없음), 15, 30 세 단계를 씁니다. 씨앗은
np.random.default_rng(1130)하나로 고정합니다. - 세 방법 모두 5×5 가우시안 블러를 먼저 합니다. Sobel 은 크기(
cv2.magnitude)가 100 을 넘는 칸, Laplacian 은 절댓값이 20 을 넘는 칸, Canny 는 기준값 50, 150 입니다. - 그림·노이즈·방법마다 허용 거리 1칸의 정밀도, 재현율, F1 을 표로 찍고, 노이즈 단계마다 방법별 평균 F1 을 찍습니다.
- 방법마다 도형 그림 한 장을 100 번 처리한 평균 시간을 재고, Canny 를 1 로 둔 배수를 찍습니다.
- 노이즈 30 의 세 그림에서 세 방법의 결과를 격자로 놓아
out_ch11_compare.jpg로 저장하고 띄웁니다. - 표를 근거로 노이즈 단계마다 추천할 방법을 고르고, 결론을 실제 숫자로 적습니다.
힌트
- 점수 함수는 본문 "성능을 숫자로 재기" 절의
edge_score를 그대로 씁니다. - 세 방법을 "이름: 함수" 사전으로 만들고, 함수마다 흑백 그림을 받아 0/255 경계 그림을 돌려주게 하면 반복문 하나로 돌릴 수 있습니다.
- 노이즈 낀 그림은 그림과 노이즈 단계마다 한 번만 만들어 세 방법에 똑같이 넣습니다. 방법마다 따로 만들면 노이즈가 달라 공평하지 않습니다.
- 시간은
time.perf_counter()를 처리 전후에 불러 뺍니다. 컴퓨터마다 값이 다르므로 배수로 견줍니다. - 표는 pandas 의
DataFrame으로 만들고,pivot_table(index="노이즈", columns="방법", values="F1")으로 평균표를 냅니다. - 큰 격자는 jpg 로 저장하면 파일이 작습니다.
plt.savefig를plt.show()보다 먼저 부릅니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 읽기와 노이즈 | 그림·정답을 짝지어 읽고, 씨앗을 고정한 노이즈 세 단계를 만든다 | 15 |
| 세 방법 | 같은 블러와 정해진 값으로 세 방법을 함수로 만든다 | 20 |
| 점수표 | 허용 거리 1칸의 정밀도·재현율·F1 표와 평균표를 찍는다 | 25 |
| 시간 | 같은 그림을 여러 번 처리한 평균과 배수를 찍는다 | 10 |
| 격자 그림 | 노이즈 30 의 결과를 격자로 jpg 저장하고 띄운다 | 15 |
| 결론 | 노이즈 단계마다 추천을 실제 숫자로 적는다 | 15 |
코드의 흐름
그림의 다섯 단계를 예시 풀이의 단계와 같은 순서로 짰습니다. 셋째 단계에서 세 방법에 같은 블러와 같은 노이즈 그림을 넣어야 공평한 비교가 됩니다. 넷째 단계는 F1 하나만 보지 않고 정밀도와 재현율을 함께 보아, 점수가 낮은 까닭이 헛것인지 빠뜨림인지 가립니다.
실제 데이터로 해 보려면
실제 사진으로 해 보려면 경계 검출 연구에 널리 쓰이는 공개 자료처럼, 사람이 테두리를 그어 정답 경계를 함께 공개한 데이터를 찾아 내려받습니다. AI Hub(aihub.or.kr)에도 물체의 테두리나 영역을 표시한 이미지 자료가 있습니다. 내려받기 전에 데이터마다 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 사람이 찍힌 사진은 얼굴 같은 개인정보가 드러나지 않게 다룹니다. 사람이 그은 정답은 실제 경계에서 몇 칸씩 어긋나므로, 허용 거리를 1칸보다 넉넉하게(예: 그림 대각선 길이의 1% 안팎) 잡는 것이 보통입니다.
결과 보기 (예시 풀이)
1단계. 그림과 정답 읽고 노이즈 만들기
import time
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

names = ["shapes", "parts", "letters"]
levels = [0, 15, 30]
images, answers = {}, {}
for n in names:
    # 요구사항 1: 그림과 정답 경계를 짝지어 흑백으로 읽는다
    images[n] = cv2.imread(f"ch11_set/{n}.png", cv2.IMREAD_GRAYSCALE)
    answers[n] = cv2.imread(f"ch11_set/{n}_edge.png", cv2.IMREAD_GRAYSCALE)
    print(f"{n:7}: 모양 {images[n].shape}, 정답 경계 칸 비율 {round(float((answers[n] > 0).mean()), 3)}")

# 요구사항 2: 씨앗 하나로 고정하고, 그림·노이즈 단계마다 노이즈 낀 그림을 한 번만 만든다
rng = np.random.default_rng(1130)
noisy = {}
for n in names:
    for s in levels:
        if s == 0:
            noisy[(n, s)] = images[n]
        else:
            noisy[(n, s)] = np.clip(images[n].astype(np.float64) + rng.normal(0, s, images[n].shape),
                                    0, 255).astype(np.uint8)
print("만든 그림:", len(noisy), "장")shapes : 모양 (240, 320), 정답 경계 칸 비율 0.02
parts : 모양 (240, 320), 정답 경계 칸 비율 0.017
letters: 모양 (240, 320), 정답 경계 칸 비율 0.029
만든 그림: 9 장2단계. 세 방법과 점수 함수 정하기
# 요구사항 3: 세 방법 모두 5×5 가우시안 블러를 먼저 한다
def sobel_edges(gray):
    b = cv2.GaussianBlur(gray, (5, 5), 0)
    gx = cv2.Sobel(b, cv2.CV_64F, 1, 0)
    gy = cv2.Sobel(b, cv2.CV_64F, 0, 1)
    return np.where(cv2.magnitude(gx, gy) > 100, 255, 0).astype(np.uint8)

def laplacian_edges(gray):
    b = cv2.GaussianBlur(gray, (5, 5), 0)
    return np.where(np.abs(cv2.Laplacian(b, cv2.CV_64F)) > 20, 255, 0).astype(np.uint8)

def canny_edges(gray):
    b = cv2.GaussianBlur(gray, (5, 5), 0)
    return cv2.Canny(b, 50, 150)

methods = {"Sobel": sobel_edges, "Laplacian": laplacian_edges, "Canny": canny_edges}

def edge_score(edges, answer):
    """허용 거리 1칸으로 (정밀도, 재현율, F1) 을 돌려준다(본문의 함수)."""
    kernel = np.ones((3, 3), np.uint8)
    found, real = edges > 0, answer > 0
    precision = (found & (cv2.dilate(answer, kernel) > 0)).sum() / max(found.sum(), 1)
    recall = (real & (cv2.dilate(edges, kernel) > 0)).sum() / real.sum()
    f1 = 2 * precision * recall / (precision + recall) if precision + recall > 0 else 0.0
    return round(float(precision), 3), round(float(recall), 3), round(float(f1), 3)

# 깨끗한 도형 그림으로 세 방법이 잘 도는지 먼저 본다
for name, func in methods.items():
print(f"{name:9}: {edge_score(func(images['shapes']), answers['shapes'])}")Sobel : (0.91, 0.753, 0.824)
Laplacian: (0.768, 0.305, 0.437)
Canny : (1.0, 0.753, 0.859)3단계. 점수표 만들기
rows, outputs = [], {}
for n in names:
    for s in levels:
        for name, func in methods.items():
            e = func(noisy[(n, s)])
            outputs[(n, s, name)] = e
            p, r, f = edge_score(e, answers[n])
            rows.append({"그림": n, "노이즈": s, "방법": name, "정밀도": p, "재현율": r, "F1": f})

report = pd.DataFrame(rows)
# 요구사항 4: 그림·노이즈·방법마다의 점수
print(report.to_string(index=False))

# 노이즈 단계마다 방법별 평균 F1
mean_f1 = report.pivot_table(index="노이즈", columns="방법", values="F1").round(3)
print()
print("[노이즈 단계마다 방법별 평균 F1]")
print(mean_f1[list(methods)]) 그림 노이즈 방법 정밀도 재현율 F1
shapes 0 Sobel 0.910 0.753 0.824
shapes 0 Laplacian 0.768 0.305 0.437
shapes 0 Canny 1.000 0.753 0.859
shapes 15 Sobel 0.902 0.882 0.892
shapes 15 Laplacian 0.779 0.334 0.468
shapes 15 Canny 0.994 0.903 0.946
shapes 30 Sobel 0.757 0.918 0.830
shapes 30 Laplacian 0.364 0.564 0.442
shapes 30 Canny 0.269 0.991 0.423
parts 0 Sobel 0.899 1.000 0.947
parts 0 Laplacian 0.796 0.710 0.750
parts 0 Canny 1.000 1.000 1.000
parts 15 Sobel 0.885 1.000 0.939
parts 15 Laplacian 0.791 0.766 0.778
parts 15 Canny 1.000 1.000 1.000
parts 30 Sobel 0.768 1.000 0.869
parts 30 Laplacian 0.432 0.846 0.572
parts 30 Canny 0.287 0.999 0.445
letters 0 Sobel 0.815 1.000 0.898
letters 0 Laplacian 0.683 0.831 0.750
letters 0 Canny 1.000 1.000 1.000
letters 15 Sobel 0.813 1.000 0.897
letters 15 Laplacian 0.705 0.930 0.802
letters 15 Canny 1.000 1.000 1.000
letters 30 Sobel 0.754 1.000 0.860
letters 30 Laplacian 0.554 0.956 0.702
letters 30 Canny 0.437 1.000 0.608
[노이즈 단계마다 방법별 평균 F1]
방법 Sobel Laplacian Canny
노이즈
0 0.890 0.646 0.953
15 0.909 0.683 0.982
30 0.853 0.572 0.4924단계. 걸린 시간 재기
# 요구사항 5: 도형 그림 한 장을 100 번 처리한 평균 시간(밀리초)
times = {}
for name, func in methods.items():
    func(images["shapes"])                    # 첫 실행의 준비 시간을 빼려고 한 번 먼저 돌린다
    start = time.perf_counter()
    for _ in range(100):
        func(images["shapes"])
    times[name] = (time.perf_counter() - start) / 100 * 1000
for name in methods:
print(f"{name:9}: {round(times[name], 3)} ms, Canny 의 {round(times[name] / times['Canny'], 1)}배")Sobel : 0.999 ms, Canny 의 5.5배
Laplacian: 0.73 ms, Canny 의 4.0배
Canny : 0.18 ms, Canny 의 1.0배5단계. 노이즈 30 의 결과를 격자로 저장하기
fig, axes = plt.subplots(len(names), 4, figsize=(10, 6))
for i, n in enumerate(names):
    panels = [("노이즈 30 그림", noisy[(n, 30)])] + [(name, outputs[(n, 30, name)]) for name in methods]
    for j, (title, im) in enumerate(panels):
        axes[i, j].imshow(im, cmap="gray", vmin=0, vmax=255)
        if i == 0:
            axes[i, j].set_title(title)
        axes[i, j].set_xticks([])
        axes[i, j].set_yticks([])
    axes[i, 0].set_ylabel(n)
plt.tight_layout()
# 요구사항 6: 저장을 먼저 하고 띄운다. 큰 격자라 jpg 로
plt.savefig("out_ch11_compare.jpg", dpi=80)
print("저장: out_ch11_compare.jpg")
plt.show()저장: out_ch11_compare.jpg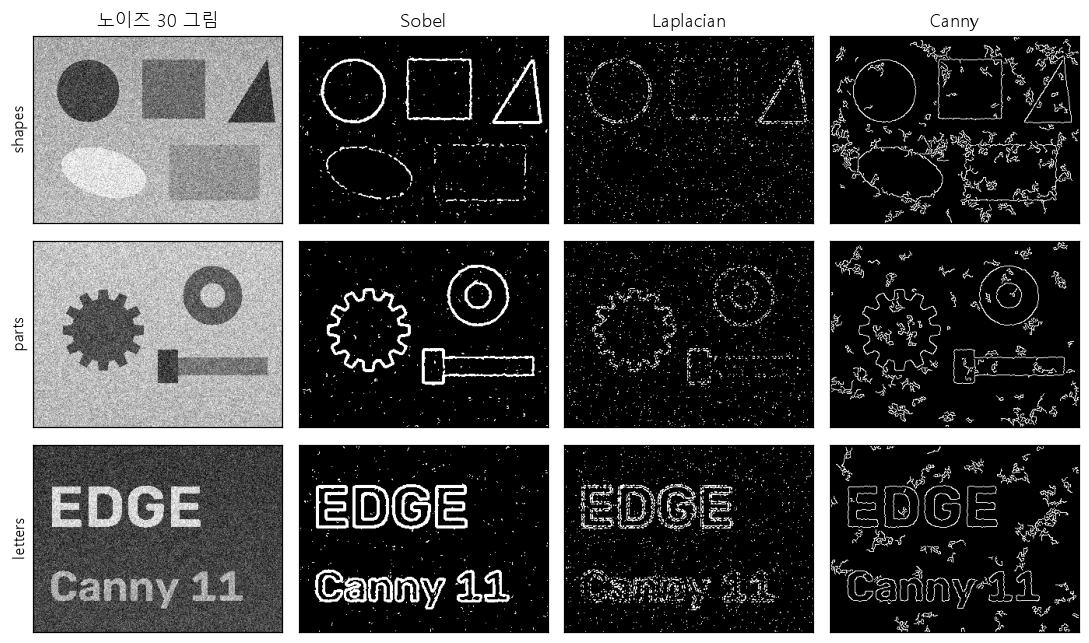
6단계. 노이즈 30 에서 Canny 기준값 올려 보기
# 결론을 쓰기 전에 하나 더 확인한다: 노이즈가 많을 때 Canny 의 기준값을 올리면 어떻게 될까
for n in names:
    b = cv2.GaussianBlur(noisy[(n, 30)], (5, 5), 0)
    for low, high in [(50, 150), (100, 200)]:
print(f"{n:7} Canny {low:3}, {high}: {edge_score(cv2.Canny(b, low, high), answers[n])}")shapes Canny 50, 150: (0.269, 0.991, 0.423)
shapes Canny 100, 200: (0.956, 0.788, 0.864)
parts Canny 50, 150: (0.287, 0.999, 0.445)
parts Canny 100, 200: (0.981, 0.993, 0.987)
letters Canny 50, 150: (0.437, 1.0, 0.608)
letters Canny 100, 200: (0.993, 1.0, 0.997)표를 보면 노이즈가 없거나 적을 때(0, 15)는 Canny 가 평균 F1 0.953, 0.982 로 가장 높습니다. Sobel 은 0.890, 0.909 로 뒤를 잇는데, 재현율은 높아도 정밀도가 0.81~0.91 에 머뭅니다. 선이 몇 칸 두께라 허용 거리 1칸을 벗어난 칸이 생기기 때문입니다. Laplacian 은 0.646, 0.683 으로 가장 낮고, 특히 도형 그림에서 재현율이 0.305~0.334 로 약한 테두리를 많이 놓쳤습니다. 노이즈가 30 으로 커지면 순위가 뒤집혀 Sobel 0.853, Laplacian 0.572, Canny 0.492 가 됩니다. Canny 는 재현율이 0.991~1.0 으로 경계를 다 찾았지만 정밀도가 0.269~0.437 로 떨어져, 격자 그림처럼 바탕에 노이즈의 고리 모양이 잔뜩 남았습니다. 그런데 6단계처럼 기준값을 100, 200 으로 올리면 Canny 의 F1 이 0.864, 0.987, 0.997 로 세 그림 모두 Sobel(0.830, 0.869, 0.860)보다 높아집니다. 걸린 시간은 Sobel 이 Canny 의 5.5배, Laplacian 이 4.0배였습니다(컴퓨터마다, 돌릴 때마다 값은 조금씩 다릅니다). Canny 가 단계는 가장 많지만 OpenCV 안에서 한 번에 처리하고, 나머지 둘은 실수 계산과 NumPy 비교를 따로 하기 때문입니다. 그래서 수업에서는 이렇게 추천합니다. 노이즈가 적으면 5×5 블러 뒤 Canny(50, 150), 노이즈가 많으면 Canny 의 기준값을 올려(이 그림들에서는 100, 200) 씁니다. 기준값을 손볼 수 없는 상황이면 노이즈에 덜 흔들린 Sobel + 임계값이 무난했습니다. Laplacian + 임계값은 테두리 선을 얻는 용도로는 추천하지 않습니다. 깨끗한 도형 그림에서도 Canny 의 재현율이 0.753 인 것은 5×5 블러가 약한 네모의 기울기를 낮춘 탓이니, 블러 크기도 그림에 맞춰 고릅니다.