20장. 교육 콘텐츠 설계와 종합 실습
프로젝트 1 — 부품 검사 수업 데모 만들기
다음 달에 "AI 비전 부품 검사" 수업을 여는 강사라고 해 봅시다. 수업 첫 시간에 "사진이 들어오면 이렇게 처리되어 결과가 나온다"는 데모를 처음부터 끝까지 보여 주고, 수강생에게 학습지를 나눠 주려고 합니다. 과정 전체에서 배운 것을 이어, 부품 사진 폴더를 정제하고, 보정하고, 18장의 모델로 탐지하고, 탐지 상자 안에서 넓이를 재고, 정답과 견줘 채점한 뒤 보고 그림, 결과 표, 학습지를 만들어 보세요.
데이터는 ch20_demo/ 입니다. 17장에서 쓴 것과 같은 양식(짙은 회녹색 벨트 위의 bolt, nut, washer)으로 OpenCV 로 그린 가상의 부품 사진이고, 강사가 수업을 준비한다는 상황은 연습을 위해 지어낸 것입니다. 모델은 18장 실습 2에서 학습한 out_ch18_runs/parts/weights/best.pt 를 씁니다. 없으면 18장 실습 2를 먼저 실행하세요.
| 파일 | 내용 |
|---|---|
ch20_demo/part_01.png ~ part_08.png | 부품 사진 8장(320×240). part_03·06 은 어둡고, part_04·07 은 소금·후추 잡티가 끼어 있다 |
ch20_demo/part_09.png | 내려받다 끊긴 것처럼 앞부분만 남은 파일 |
ch20_demo/part_10.png | part_02 와 바이트까지 같은 사본 |
ch20_demo/answer.csv | 정답표: filename, class, x1, y1, x2, y2, area(부품 바깥 모양의 칸 수, 구멍 포함) |
정답표는 채점용입니다. 정제, 보정, 탐지, 측정 단계에서는 쓰지 말고, 5단계 채점과 7단계 학습지에서만 씁니다.
요구사항
- 폴더의 그림을 이름순으로 읽어, 읽히지 않는 파일과 MD5 가 앞의 그림과 같은 파일을 이유와 함께 빼고 표로 찍습니다(16장).
- 남은 그림마다 흑백 평균 밝기와 잡티 비율을 재고, 평균이 45 미만이면 정규화(5장), 잡티 비율이 0.002 를 넘으면 Median 3(7장)으로 고칩니다. 그림마다 무엇을 했는지 표로 찍습니다.
- 고친 그림을 18장의 모델로 탐지해 상자마다 파일, 클래스, 신뢰도, x1, y1, x2, y2 를 표로 모읍니다.
- 탐지 상자마다 상자 안(테두리 4칸 여유)에서 Otsu 이진화와 바깥 윤곽선으로 가장 큰 부품의 넓이와 원형도(13장)를 잽니다.
- 정답표와 견줘, 같은 클래스이면서 IoU 0.5 이상인 상자를 맞힘으로 셉니다. 정밀도, 재현율, 맞힌 상자의 넓이 오차(%)를 찍고 표를
out_ch20_final.csv로 저장합니다. - 고친 그림 8장에 맞힌 상자와 틀린 상자를 다른 색으로 그린 격자와 클래스별 정답·탐지 개수 막대를 한 그림에 모아
out_ch20_final.png로 저장하고 띄웁니다. - part_08 의 원본 그림에 부품마다 번호를 붙이고, 오른쪽에 "번호, 부품 이름, 넓이" 빈칸 표를 둔 학습지를
out_ch20_worksheet.png로 저장하고, 강사용 정답을 찍습니다. - 결론을 실제 숫자로 적습니다.
힌트
- 16장의
md5_of를 그대로 가져와, 지금까지 본 MD5 를 사전에 담아 두고 같은 값이 나오면 뺍니다. - 잡티 비율은 흑백 그림과 Median 3 을 건 그림의 차이가 60 을 넘는 칸의 비율로 잽니다. 소금·후추 점은 Median 이 지우므로 차이가 크게 납니다.
- 탐지 결과는
r.boxes.xyxy.cpu().numpy(),r.boxes.conf.cpu().numpy(),r.boxes.cls.cpu().numpy().astype(int)로 꺼내고, 이름은r.names[번호]로 얻습니다(18장). - 원형도는 4 × π × 넓이 ÷ 둘레² 입니다(13장). 원에 가까운 와셔는 1 에 가깝고 길쭉한 볼트는 작습니다.
- 맞힘 판정은 정답 상자마다 아직 짝이 없는 같은 클래스의 탐지 상자 가운데 IoU 가 가장 큰 것을 고르고, 0.5 이상이면 짝짓습니다. 짝 없는 탐지 상자는 헛것, 짝 없는 정답 상자는 놓친 것입니다.
- 학습지는 Matplotlib 으로 왼쪽에 그림, 오른쪽에
ax.table로 빈칸 표를 그립니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 정제 | 깨진 파일과 같은 사진을 이유와 함께 뺀다 | 10 |
| 보정 | 밝기와 잡티를 재어 그림마다 알맞게 고치고 표로 보인다 | 15 |
| 탐지 | 18장의 모델로 탐지해 상자 표를 만든다 | 15 |
| 측정 | 상자 안에서 넓이와 원형도를 잰다 | 15 |
| 채점 | IoU 0.5 로 짝지어 정밀도, 재현율, 넓이 오차를 찍고 저장한다 | 20 |
| 보고 그림 | 맞힘과 틀림을 색으로 가른 격자와 개수 막대를 저장한다 | 10 |
| 학습지 | 번호 붙인 문제 그림과 빈칸 표를 저장하고 정답을 찍는다 | 5 |
| 결론 | 실제 숫자로 적는다 | 10 |
코드의 흐름
그림의 다섯 단계를 예시 풀이의 1단계부터 6단계까지와 같은 순서로 짰고, 7단계의 학습지는 맨 끝에 덧붙였습니다. 단계 사이에는 사전 kept(파일 이름 → 그림)와 표 det(탐지 상자 한 줄에 하나)가 바통처럼 넘어갑니다. 정답표는 다섯째 단계에 처음 들어옵니다.
실제 데이터로 해 보려면
실제 부품 사진으로 해 보려면 AI Hub(aihub.or.kr)에서 제조 부품이나 공정 검사처럼 상자 주석이 함께 있는 이미지 자료를 찾아 내려받습니다. 내려받기 전에 이용 약관(상업적 이용 가능 여부, 재배포 금지, 수업 자료로 나눠 줘도 되는지)을 확인하고, 작업자의 얼굴이나 이름표처럼 개인정보가 찍힌 사진은 빼거나 가린 뒤 씁니다. 실제 사진은 클래스와 모양이 이 데모와 다르므로, 17장처럼 데이터셋을 만들어 18장처럼 다시 학습한 모델을 써야 합니다. 정제와 보정의 기준값(밝기 45, 잡티 0.002)도 16장처럼 분포를 먼저 그려 본 뒤 정합니다. 수업 데모로 나눠 줄 때는 자료의 출처와 라이선스를 README 에 적습니다.
결과 보기 (예시 풀이)
1단계. 정제: 깨진 파일과 같은 사진 빼기
import os
import hashlib
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

folder = "ch20_demo"
names = sorted(n for n in os.listdir(folder) if n.endswith(".png"))

def md5_of(path):
    """파일의 바이트로 MD5 지문을 만든다(16차시). 바이트가 같으면 지문도 같다."""
    with open(path, "rb") as f:
        return hashlib.md5(f.read()).hexdigest()

kept, removed, seen = {}, [], {}
for name in names:
    path = os.path.join(folder, name)
    img = cv2.imread(path)
    if img is None:
        removed.append({"파일": name, "이유": "읽기 실패"})
        continue
    digest = md5_of(path)
    if digest in seen:                         # 앞에서 본 지문이면 같은 사진
        removed.append({"파일": name, "이유": f"{seen[digest]} 와 같은 사진"})
        continue
    seen[digest] = name
    kept[name] = img

print("남은 그림:", len(kept), "장")
print(pd.DataFrame(removed).to_string(index=False))남은 그림: 8 장
파일 이유
part_09.png 읽기 실패
part_10.png part_02.png 와 같은 사진2단계. 보정: 어두움과 잡티 고치기
def dust_ratio(img):
    """흑백 그림과 Median 3 을 건 그림의 차이가 60 을 넘는 칸의 비율. 소금·후추 잡티가 많을수록 크다."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    return float((cv2.absdiff(gray, cv2.medianBlur(gray, 3)) > 60).mean())

fixed, log = {}, []
for name, img in kept.items():
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    mean_before, dust = float(gray.mean()), dust_ratio(img)
    done = []
    if mean_before < 45:                                          # 어두우면 0~255 로 늘린다(5차시)
        img = cv2.normalize(img, None, 0, 255, cv2.NORM_MINMAX)
        done.append("정규화")
    if dust > 0.002:                                              # 잡티가 많으면 Median(7차시)
        img = cv2.medianBlur(img, 3)
        done.append("Median 3")
    fixed[name] = img
    log.append({"파일": name, "밝기 전": round(mean_before, 1),
                "밝기 후": round(float(cv2.cvtColor(img, cv2.COLOR_BGR2GRAY).mean()), 1),
                "잡티 비율": round(dust, 4), "손질": " + ".join(done) or "그대로"})
print(pd.DataFrame(log).to_string(index=False)) 파일 밝기 전 밝기 후 잡티 비율 손질
part_01.png 72.2 72.2 0.0000 그대로
part_02.png 69.5 69.5 0.0000 그대로
part_03.png 30.0 46.0 0.0000 정규화
part_04.png 76.2 75.0 0.0050 Median 3
part_05.png 72.8 72.8 0.0000 그대로
part_06.png 33.7 59.8 0.0000 정규화
part_07.png 76.3 75.0 0.0055 Median 3
part_08.png 73.0 73.0 0.0000 그대로3단계. 탐지: 18차시의 모델로 상자 찾기
os.environ["YOLO_VERBOSE"] = "False"         # 불러오기 전에 정해야 긴 진행 글이 줄어든다
from ultralytics import YOLO

model_path = "out_ch18_runs/parts/weights/best.pt"
if not os.path.exists(model_path):
    raise SystemExit("모델이 없습니다. 18차시 실습 2를 먼저 실행하세요")
model = YOLO("out_ch18_runs/parts/weights/best.pt")

rows = []
for name, img in fixed.items():
    # 고친 그림(BGR 배열)을 그대로 넣는다. imgsz 는 학습 때와 같은 320
    r = model.predict(img, imgsz=320, conf=0.25, device="cpu", verbose=False)[0]
    boxes = r.boxes.xyxy.cpu().numpy()
    confs = r.boxes.conf.cpu().numpy()
    classes = r.boxes.cls.cpu().numpy().astype(int)
    for (x1, y1, x2, y2), c, k in zip(boxes, confs, classes):
        rows.append({"파일": name, "클래스": r.names[int(k)], "신뢰도": round(float(c), 3),
                     "x1": int(round(float(x1))), "y1": int(round(float(y1))),
                     "x2": int(round(float(x2))), "y2": int(round(float(y2)))})
det = pd.DataFrame(rows)
print("탐지한 상자:", len(det), "개")
print(det["클래스"].value_counts().to_dict())
print(det.head(6).to_string(index=False))탐지한 상자: 19 개
{'washer': 7, 'bolt': 7, 'nut': 5}
파일 클래스 신뢰도 x1 y1 x2 y2
part_01.png washer 0.962 276 160 305 188
part_01.png nut 0.928 138 192 170 227
part_02.png bolt 0.985 152 124 212 222
part_02.png washer 0.980 272 96 303 127
part_02.png bolt 0.975 57 63 124 108
part_03.png bolt 0.928 184 49 218 1084단계. 측정: 상자 안에서 넓이와 원형도 재기
def measure(img, x1, y1, x2, y2, pad=4):
    """상자 안(테두리 pad 칸 여유)을 Otsu 로 이진화해 가장 큰 바깥 윤곽선의 넓이와 원형도를 돌려준다."""
    h, w = img.shape[:2]
    x1, y1 = max(x1 - pad, 0), max(y1 - pad, 0)
    x2, y2 = min(x2 + pad, w), min(y2 + pad, h)
    roi = cv2.cvtColor(img[y1:y2, x1:x2], cv2.COLOR_BGR2GRAY)       # ROI: 상자 안만 잘라 낸다(13차시)
    _, binary = cv2.threshold(roi, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    contours, _ = cv2.findContours(binary, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    if not contours:
        return 0, 0.0
    c = max(contours, key=cv2.contourArea)                          # 가장 큰 덩어리가 부품
    area, perimeter = cv2.contourArea(c), cv2.arcLength(c, True)
    circularity = 4 * np.pi * area / perimeter ** 2 if perimeter else 0.0
    return int(round(area)), round(float(circularity), 3)

measured = [measure(fixed[r.파일], r.x1, r.y1, r.x2, r.y2) for r in det.itertuples()]
det["넓이"] = [m[0] for m in measured]
det["원형도"] = [m[1] for m in measured]
# 클래스마다 원형도 평균: 와셔·너트는 크고 볼트는 작을 것이다
print(det.groupby("클래스")[["넓이", "원형도"]].mean().round(3)) 넓이 원형도
클래스
bolt 1463.0 0.336
nut 828.2 0.760
washer 909.0 0.9185단계. 채점: 정답과 견주기
answer = pd.read_csv("ch20_demo/answer.csv")

def iou(a, b):
    """두 상자 (x1, y1, x2, y2) 의 IoU: 겹친 넓이 ÷ 합친 넓이."""
    ix = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    iy = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = ix * iy
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter
    return inter / union if union else 0.0

det["판정"], det["IoU"], det["정답 넓이"] = "헛것", 0.0, np.nan
missed = 0
for t in answer.itertuples():
    gt = (t.x1, t.y1, t.x2, t.y2)
    # 같은 그림, 같은 클래스, 아직 짝이 없는 탐지 상자 가운데 IoU 가 가장 큰 것
    cand = det[(det["파일"] == t.filename) & (det["클래스"] == t._2) & (det["판정"] == "헛것")]
    best_i, best_v = None, 0.0
    for i, r in cand.iterrows():
        v = iou(gt, (r.x1, r.y1, r.x2, r.y2))
        if v > best_v:
            best_i, best_v = i, v
    if best_i is not None and best_v >= 0.5:
        det.loc[best_i, ["판정", "IoU", "정답 넓이"]] = ["맞힘", round(best_v, 3), t.area]
    else:
        missed += 1

tp = int((det["판정"] == "맞힘").sum())
precision, recall = tp / len(det), tp / len(answer)
hit = det[det["판정"] == "맞힘"]
err = ((hit["넓이"] - hit["정답 넓이"]) / hit["정답 넓이"] * 100).round(1)
det.loc[hit.index, "넓이 오차(%)"] = err
print(f"정답 {len(answer)}개, 탐지 {len(det)}개, 맞힘 {tp}, 헛것 {len(det) - tp}, 놓침 {missed}")
print(f"정밀도 {precision:.3f}, 재현율 {recall:.3f}")
print("클래스별 넓이 오차 평균(%):", det.groupby("클래스")["넓이 오차(%)"].mean().round(1).to_dict())
det.to_csv("out_ch20_final.csv", index=False, encoding="utf-8-sig")정답 18개, 탐지 19개, 맞힘 18, 헛것 1, 놓침 0
정밀도 0.947, 재현율 1.000
클래스별 넓이 오차 평균(%): {'bolt': -3.5, 'nut': -13.8, 'washer': 3.0}6단계. 보고 그림 만들기
fig = plt.figure(figsize=(13, 8))
grid = fig.add_gridspec(3, 4, height_ratios=[1, 1, 1.1])
for k, (name, img) in enumerate(fixed.items()):
    view = img.copy()
    for r in det[det["파일"] == name].itertuples():
        color = (0, 200, 0) if r.판정 == "맞힘" else (0, 0, 255)    # BGR: 맞힘 초록, 헛것 빨강
        cv2.rectangle(view, (r.x1, r.y1), (r.x2, r.y2), color, 2)
        # 이름은 상자 위에 쓰고, 상자가 그림 위쪽 끝에 붙어 있으면 상자 아래에 쓴다
        text_y = r.y1 - 4 if r.y1 >= 14 else r.y2 + 13
        cv2.putText(view, r.클래스, (r.x1, text_y), cv2.FONT_HERSHEY_SIMPLEX, 0.45, color, 1)
    ax = fig.add_subplot(grid[k // 4, k % 4])
    ax.imshow(cv2.cvtColor(view, cv2.COLOR_BGR2RGB))
    ax.set_title(name)
    ax.axis("off")

# 아래 줄: 클래스별 정답 개수와 탐지 개수
bar = fig.add_subplot(grid[2, :])
classes = ["bolt", "nut", "washer"]
gt_n = [int((answer["class"] == c).sum()) for c in classes]
det_n = [int((det["클래스"] == c).sum()) for c in classes]
hit_n = [int(((det["클래스"] == c) & (det["판정"] == "맞힘")).sum()) for c in classes]
x = np.arange(len(classes))
bar.bar(x - 0.27, gt_n, width=0.27, label="정답")
bar.bar(x, det_n, width=0.27, label="탐지")
bar.bar(x + 0.27, hit_n, width=0.27, label="맞힘")
bar.set_xticks(x, labels=classes)
bar.set_ylim(0, max(gt_n + det_n) + 2)
bar.legend(loc="upper center", ncol=3)
fig.suptitle(f"부품 검사 데모: 정밀도 {precision:.3f}, 재현율 {recall:.3f}", fontsize=15)
fig.tight_layout()
fig.savefig("out_ch20_final.png", dpi=100)
plt.show()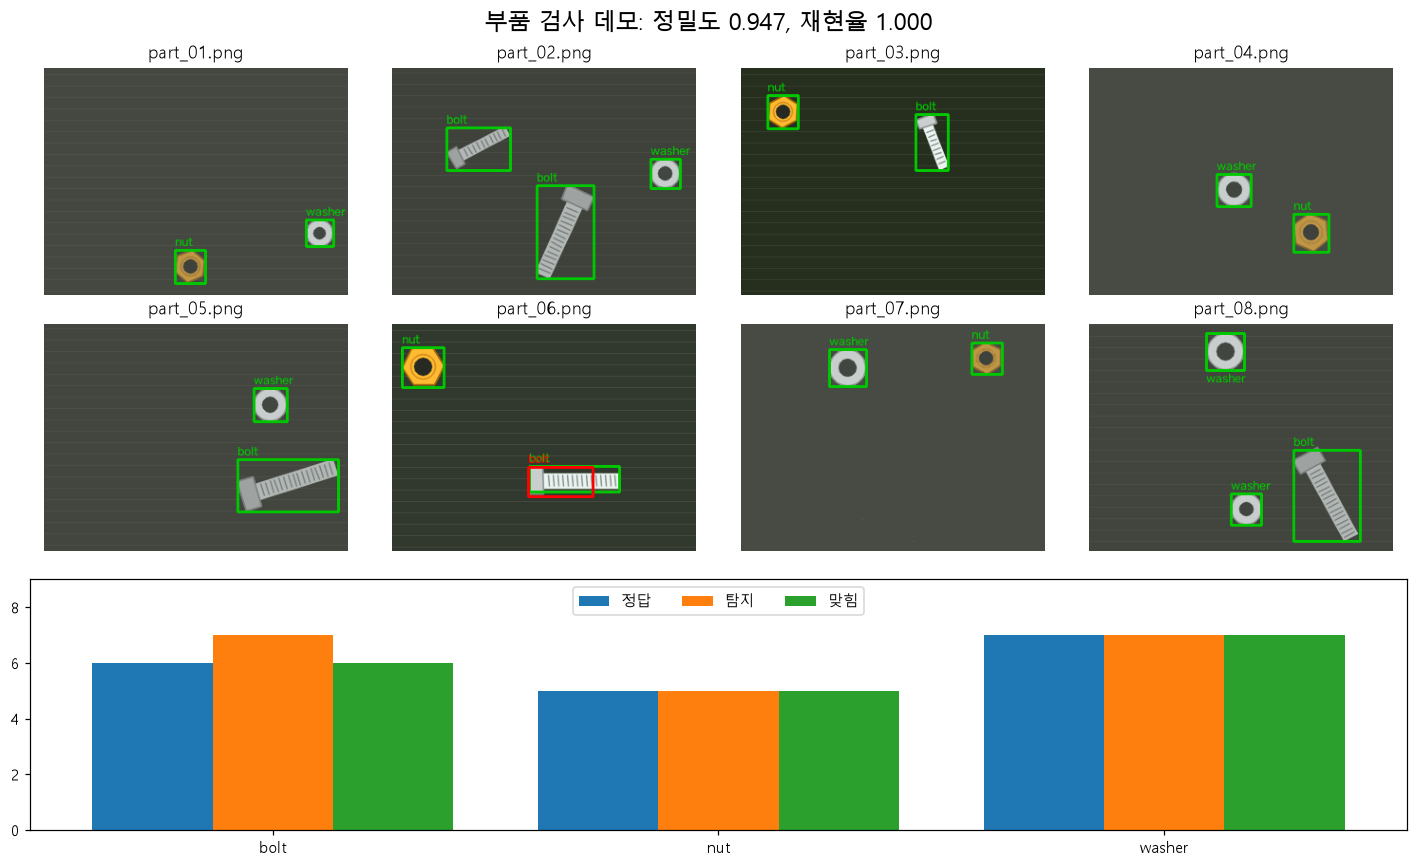
7단계. 학습지 만들기
sheet_name = "part_08.png"
problem = cv2.imread(os.path.join(folder, sheet_name))
key = answer[answer["filename"] == sheet_name].reset_index(drop=True)

view = problem.copy()
for k, t in key.iterrows():
    # 부품 위가 아니라 상자의 왼쪽 위 바깥에 번호를 둔다(부품을 가리지 않게)
    x, y = max(t.x1 - 14, 2), max(t.y1 - 2, 14)
    cv2.putText(view, str(k + 1), (x, y), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 255), 2)

fig, (left, right) = plt.subplots(1, 2, figsize=(11, 4.2), width_ratios=[1.2, 1])
left.imshow(cv2.cvtColor(view, cv2.COLOR_BGR2RGB))
left.set_title("문제: 번호마다 부품 이름을 적고 넓이(칸)를 코드로 재어 보세요")
left.axis("off")
right.axis("off")
cells = [[str(k + 1), "", ""] for k in range(len(key))]
table = right.table(cellText=cells, colLabels=["번호", "부품 이름", "넓이(칸)"], loc="center", cellLoc="center")
table.scale(1, 2.4)                       # 칸 높이를 키워 손으로 쓸 자리를 만든다
table.set_fontsize(13)
fig.suptitle("부품 검사 학습지 (가상 그림)", fontsize=15)
fig.tight_layout()
fig.savefig("out_ch20_worksheet.png", dpi=100)

print("[강사용 정답]")
print(key.assign(번호=range(1, len(key) + 1))[["번호", "class", "area"]].to_string(index=False))
plt.show()[강사용 정답]
번호 class area
1 washer 797
2 bolt 1923
3 washer 1129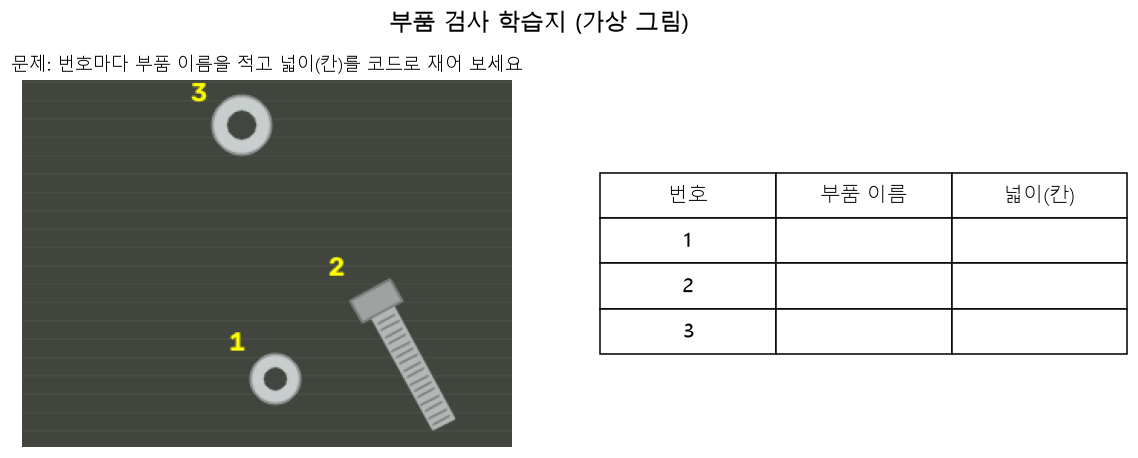
정제 단계에서 읽히지 않는 part_09.png 와 part_02.png 의 사본인 part_10.png 가 빠져 8장이 남았습니다. 보정 단계에서는 어두운 part_03·06(평균 밝기 30.0, 33.7)이 정규화로 46.0, 59.8 이 되었고, 잡티 비율이 0.0050, 0.0055 인 part_04·07 에 Median 3 을 걸었습니다. 18장의 모델은 상자 19개를 찾았고, 정답 18개를 모두 맞혀(놓침 0) 재현율 1.000, 헛것 1개로 정밀도 0.947 입니다. 맞힌 상자의 IoU 는 0.849~1.0 입니다. 헛것은 어두운 part_06 의 볼트 하나에 상자가 하나 더 겹쳐 나온 것으로, 신뢰도가 0.661 로 다른 상자(0.894 이상)보다 낮습니다. 볼트의 머리와 몸통 앞쪽만 덮은 짧은 상자입니다. 18장에서 이 모델은 어두운 그림에는 강하고 잡음에는 약했습니다(잡음 F1 0.815). 이 데모에서는 Median 3 으로 잡티를 지운 part_04·07 의 부품 네 개를 모두 IoU 0.915 이상으로 맞혔습니다. 잡음에 약한 모델이라도 앞 단계의 보정이 그 약점을 메운 것입니다. 어두운 그림은 정규화 뒤에도 바탕이 다른 그림보다 어두워(평균 46.0, 59.8), 하나뿐인 헛것과 가장 낮은 IoU(0.849, part_06 의 볼트)가 모두 이 그림에서 나왔습니다. 넓이 오차의 평균은 bolt −3.5%, nut −13.8%, washer +3.0% 입니다. 너트는 −8.2%~−17.6% 로 늘 작게 재집니다. 너트의 바깥 테두리 선이 몸통보다 어둡게 그려져 있어 Otsu 가 그 선을 바탕 쪽으로 나누기 때문입니다. 정답 넓이는 테두리까지 센 칸 수입니다. 원형도의 평균은 washer 0.918, nut 0.760, bolt 0.336 으로, 둥근 와셔가 가장 크고 길쭉한 볼트가 가장 작습니다(볼트 평균에는 헛것 상자의 0.414 도 들어 있습니다). 수업에서는 이 그림과 표를 데모로 보여 주고, 학습지(part_08 의 부품 3개, 강사용 정답 washer 797, bolt 1923, washer 1129)를 나눠 주어 수강생이 같은 측정을 직접 해 보게 합니다. 너트의 넓이 오차는 "테두리 색이 다르면 이진화로 잰 넓이가 작아진다"는 토론거리로 쓸 수 있습니다.