16장. AI 데이터 정제와 데이터 증강
흐린 사진 찾기
안경을 벗고 칠판을 보면 글자의 테두리가 번져 보입니다. 테두리가 또렷하면 글자의 검은 획과 흰 칠판이 딱 갈라지고, 번지면 검정에서 흰색으로 천천히 바뀝니다. 흐린 사진을 찾는 방법도 이 차이를 잽니다. 밝기가 "갑자기" 바뀌는 곳이 많으면 선명하고, "천천히" 바뀌는 곳만 있으면 흐립니다.
그림의 세 걸음이 흐림 점수를 매기는 순서입니다. 10장에서 본 Laplacian 은 밝기의 변화량이 바뀌는 곳(경계)에서 큰 + 와 − 값을 내고, 평평한 곳에서는 0 을 냅니다. 선명한 사진은 경계에서 큰 값이 많아 값들이 넓게 퍼지고, 흐린 사진은 작은 값만 있어 0 근처에 모입니다. 값이 퍼진 정도를 분산으로 재면 그것이 흐림 점수입니다. 여기서 또렷한 글자 테두리가 Laplacian 의 큰 값이고, 안경을 벗었을 때의 번진 테두리가 작은 값입니다.
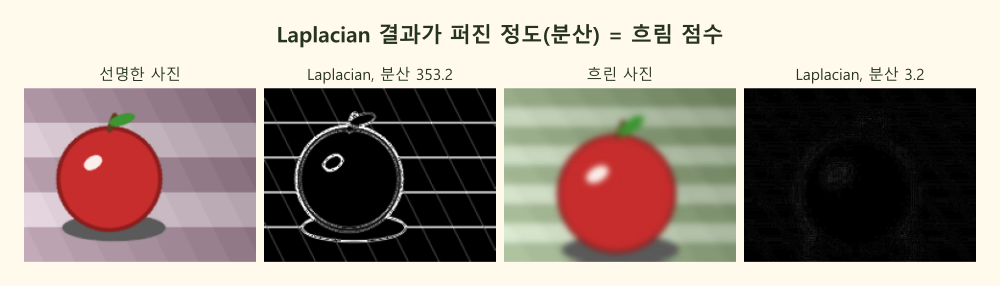
둘째와 넷째 그림은 Laplacian 결과의 크기를 4배로 키워 흑백으로 띄운 것입니다. 선명한 사과는 과일과 식탁보 무늬의 테두리가 흰 선으로 또렷하고 분산이 353.2 입니다. 흐린 사과는 거의 까맣고 분산이 3.2 입니다. 100배 넘게 차이가 납니다.
분산을 손으로 계산하기
분산은 "평균에서 떨어진 거리를 제곱해서 평균 낸 것"입니다. 4장에서 표준편차를 구할 때 ④ 단계(제곱의 평균)까지가 분산이고, 거기에 제곱근을 씌운 것이 표준편차입니다. 밝기가 50 에서 150 으로 바뀌는 경계를 가로로 지나는 한 줄로 계산해 봅니다.
| 단계 | 선명한 줄 | 흐린 줄 |
|---|---|---|
| 밝기 6칸 | 50, 50, 50, 150, 150, 150 | 50, 50, 70, 130, 150, 150 |
| ① 두 번 빼기(왼쪽 + 오른쪽 − 2 × 가운데) | 0, 100, −100, 0 | 20, 40, −40, −20 |
| ② 평균 | 0 ÷ 4 = 0 | 0 ÷ 4 = 0 |
| ③ 평균과의 차이를 제곱 | 0, 10000, 10000, 0 | 400, 1600, 1600, 400 |
| ④ 제곱의 평균 = 분산 | 20000 ÷ 4 = 5000 | 4000 ÷ 4 = 1000 |
| (표준편차 = 분산의 제곱근) | 약 70.7 | 약 31.6 |
①의 첫 칸은 50 + 50 − 2 × 50 = 0, 둘째 칸은 50 + 150 − 2 × 50 = 100 입니다. 두 줄 모두 밝기가 100 만큼 오르지만, 선명한 줄은 한 칸 만에 오르고 흐린 줄은 세 칸에 걸쳐 오릅니다. 그래서 선명한 줄의 분산이 5배 큽니다.
기준값 정하기
| 방법 | 하는 일 | 좋은 점과 아쉬운 점 |
|---|---|---|
| 정해진 숫자 | 인터넷에서 흔히 보는 100 같은 값을 그대로 쓴다 | 빠르지만, 사진 크기와 무늬에 따라 맞지 않는다 |
| 분포를 보고 | 모든 사진의 점수를 그래프로 그려, 크게 벌어진 틈에 선을 긋는다 | 데이터에 맞는다. 이 장의 방법이다 |
| 눈으로 확인 | 기준 근처의 사진 몇 장을 직접 열어 본다 | 마지막 확인에 꼭 한다 |
짧은 예시
import cv2
import numpy as np

# 손계산과 같은 두 줄: 두 번 빼기를 NumPy 로 한 번에 한다
for row in [[50, 50, 50, 150, 150, 150], [50, 50, 70, 130, 150, 150]]:
    r = np.array(row, dtype=np.float64)
    second = r[:-2] + r[2:] - 2 * r[1:-1]          # 왼쪽 + 오른쪽 - 2 × 가운데
    print(second.tolist(), float(second.var()))    # var: variance(분산)
# 결과: [0.0, 100.0, -100.0, 0.0] 5000.0
#       [20.0, 40.0, -40.0, -20.0] 1000.0

def blur_score(img):
    """흑백으로 바꾸고 Laplacian 의 분산을 돌려준다. 클수록 선명하다."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    return float(cv2.Laplacian(gray, cv2.CV_64F).var())

print(round(blur_score(cv2.imread("ch16_raw/apple_04.png")), 1))   # 결과: 353.2
print(round(blur_score(cv2.imread("ch16_raw/apple_09.jpg")), 1))   # 결과: 3.2
cv2.Laplacian 의 결과는 + 와 − 가 섞여 있어서 10장처럼 cv2.CV_64F(소수)로 받습니다. uint8 로 받으면 음수가 잘려 분산이 틀어집니다.
주의할 점
- 어두운 사진은 경계에서 밝기 차이도 작아서 흐림 점수가 낮게 나옵니다. 밝기를 먼저 고친 뒤 흐림 점수를 잽니다(실습 2).
- 무늬가 거의 없는 사진(흰 벽 앞의 흰 컵)은 선명해도 점수가 낮습니다. 점수는 "이 묶음 안에서" 견줄 때 뜻이 있습니다.
- 사진 크기가 크게 다르면 점수도 달라집니다. 같은 사진을 줄이면 경계가 촘촘해져 점수가 오릅니다. 크기가 아주 제각각이면 같은 크기로 줄인 뒤 잽니다.