16장. AI 데이터 정제와 데이터 증강
실습 2 — 흐림 점수와 밝기 점수로 품질 표 만들기
실습 1의 관문을 통과한 사진마다 평균 밝기와 흐림 점수(Laplacian 분산)를 재어 품질 표를 만듭니다. 점수의 분포를 그래프로 그려 기준값을 정하고, 어두운 사진은 밝기를 고친 뒤 다시 잽니다. 품질 표는 out_ch16_quality.csv 로 저장합니다.
1단계. 손계산을 코드로 확인하기
import os
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 본문의 두 줄: 선명한 경계와 흐린 경계
sharp = np.array([50, 50, 50, 150, 150, 150], dtype=np.float64)
soft = np.array([50, 50, 70, 130, 150, 150], dtype=np.float64)
for label, row in [("선명", sharp), ("흐림", soft)]:
    second = row[:-2] + row[2:] - 2 * row[1:-1]       # 두 번 빼기
    diff = second - second.mean()                      # 평균과의 차이
    var = float((diff ** 2).mean())                    # 제곱의 평균 = 분산
print(f"{label}: 두 번 빼기 {second.tolist()} → 분산 {var}, 표준편차 {round(float(np.sqrt(var)), 1)}")선명: 두 번 빼기 [0.0, 100.0, -100.0, 0.0] → 분산 5000.0, 표준편차 70.7
흐림: 두 번 빼기 [20.0, 40.0, -40.0, -20.0] → 분산 1000.0, 표준편차 31.62단계. 사진마다 밝기와 흐림 점수 재기
folder = "ch16_raw"

def load_bgr(path):
    """저장된 그대로 읽은 뒤 세 채널로 맞춘다. 못 읽거나 너무 작으면 None."""
    img = cv2.imread(path, cv2.IMREAD_UNCHANGED) if os.path.getsize(path) > 0 else None
    if img is None or min(img.shape[:2]) < 64:
        return None
    if img.ndim == 2:
        return cv2.cvtColor(img, cv2.COLOR_GRAY2BGR)
    if img.shape[2] == 4:
        return cv2.cvtColor(img, cv2.COLOR_BGRA2BGR)
    return img

def blur_score(img):
    """흑백으로 바꾸고 Laplacian 의 분산을 돌려준다. 클수록 선명하다."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    # CV_64F: + 와 - 를 모두 담는 소수로 받는다(uint8 이면 음수가 잘린다)
    return float(cv2.Laplacian(gray, cv2.CV_64F).var())

rows, images = [], {}
for name in sorted(n for n in os.listdir(folder) if n != "answer.csv"):
    img = load_bgr(os.path.join(folder, name))
    if img is None:
        continue                                       # 실습 1에서 버린 파일은 건너뛴다
    images[name] = img
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    rows.append({"파일": name,
                 "평균": round(float(gray.mean()), 1),
                 "어두운칸": round(float((gray < 50).mean()), 3),     # 50 미만 비율(4차시)
                 "밝은칸": round(float((gray > 205).mean()), 3),      # 205 초과 비율(4차시)
                 "흐림점수": round(blur_score(img), 1)})
quality = pd.DataFrame(rows)
print("잰 사진:", len(quality))
print(quality.sort_values("흐림점수").head(8).to_string(index=False))잰 사진: 35
파일 평균 어두운칸 밝은칸 흐림점수
apple_09.jpg 142.4 0.000 0.065 3.2
tangerine_09.jpg 160.6 0.000 0.042 4.8
lime_09.jpg 160.2 0.000 0.058 6.1
tangerine_10.png 23.9 1.000 0.000 7.9
lime_11.png 228.5 0.000 1.000 39.6
lime_10.png 62.7 0.174 0.000 67.8
tangerine_11.jpg 165.1 0.000 0.086 203.8
lime_01.png 168.6 0.000 0.123 210.33단계. 점수 분포를 보고 기준값 정하기
BLUR_MIN = 100   # 이보다 작으면 흐리다고 본다

ordered = quality.sort_values("흐림점수").reset_index(drop=True)
fig, ax = plt.subplots(figsize=(11, 3.6))
ax.bar(range(len(ordered)), ordered["흐림점수"])
# 기준선: 막대와 구별되도록 기본 색 순서의 둘째 색(C1)과 점선으로
ax.axhline(BLUR_MIN, color="C1", linestyle="--", label=f"기준값 {BLUR_MIN}")
# 점수가 3 에서 1,500 까지 퍼져 있어 세로축을 로그 눈금(10배마다 같은 간격)으로 그린다
ax.set_yscale("log")
ax.set_yticks([1, 10, 100, 1000], labels=["1", "10", "100", "1000"])
ax.minorticks_off()
ax.set_xticks(range(len(ordered)), labels=ordered["파일"], rotation=90, fontsize=8)
ax.set_ylabel("흐림 점수 (Laplacian 분산)")
ax.set_title("사진별 흐림 점수 (작은 것부터)")
ax.legend(loc="upper left")
plt.tight_layout()
plt.show()

# 기준값 아래와 위의 가장 가까운 점수: 틈이 넓을수록 기준을 정하기 쉽다
below = ordered.loc[ordered["흐림점수"] < BLUR_MIN, "흐림점수"]
above = ordered.loc[ordered["흐림점수"] >= BLUR_MIN, "흐림점수"]
print("기준 아래:", below.tolist())
print("기준 위의 가장 작은 점수:", float(above.min()))기준 아래: [3.2, 4.8, 6.1, 7.9, 39.6, 67.8]
기준 위의 가장 작은 점수: 203.8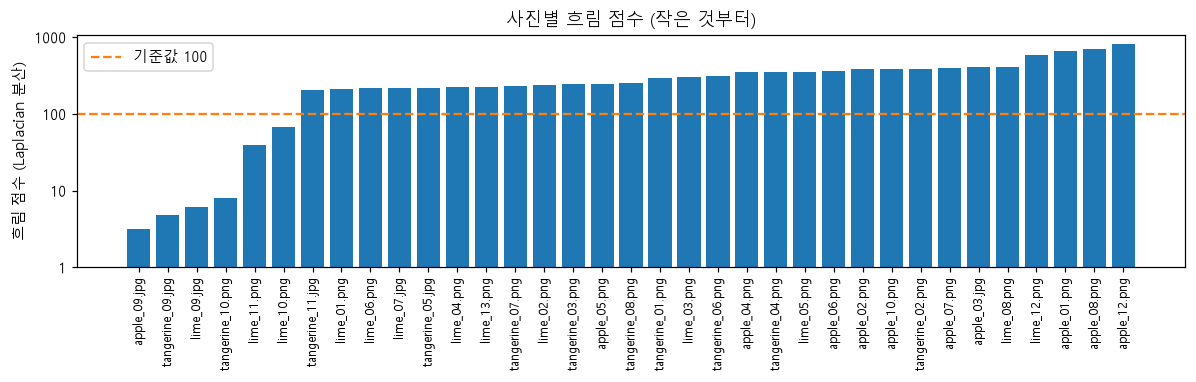
4단계. 밝기를 먼저 고친 뒤 다시 재고 판정하기
def exposure(mean, dark, bright):
    """이 장의 밝기 판정표: 위에서부터 따져 처음 맞는 줄에서 멈춘다."""
    if mean < 40:
        return "아주 어두움"
    if mean < 80 or dark > 0.4:
        return "어두움"
    if mean > 175 or bright > 0.4:
        return "밝음"
    return "정상"

quality["밝기판정"] = [exposure(r.평균, r.어두운칸, r.밝은칸) for r in quality.itertuples()]

# 어두운 사진은 정규화(5차시)로 고친 뒤 흐림 점수를 다시 잰다
after = []
for r in quality.itertuples():
    img = images[r.파일]
    if r.밝기판정 == "어두움":
        img = cv2.normalize(img, None, 0, 255, cv2.NORM_MINMAX)
    after.append(round(blur_score(img), 1))
quality["고친뒤점수"] = after

def decide(r):
    """밝기 판정 → 흐림의 순서로 최종 처리를 정한다."""
    if r.밝기판정 in ("아주 어두움", "밝음"):
        return "버림(" + r.밝기판정 + ")"
    if r.고친뒤점수 < BLUR_MIN:
        return "버림(흐림)"
    return "고침(밝기)" if r.밝기판정 == "어두움" else "그대로"

quality["처리"] = [decide(r) for r in quality.itertuples()]
cols = ["파일", "평균", "어두운칸", "밝은칸", "흐림점수", "밝기판정", "고친뒤점수", "처리"]
print(quality.loc[quality["처리"] != "그대로", cols].to_string(index=False))
print(quality["처리"].value_counts().to_dict())

# 품질 표를 저장한다. 엑셀에서 한글이 깨지지 않게 utf-8-sig 로
quality.to_csv("out_ch16_quality.csv", index=False, encoding="utf-8-sig")
print("저장: out_ch16_quality.csv") 파일 평균 어두운칸 밝은칸 흐림점수 밝기판정 고친뒤점수 처리
apple_09.jpg 142.4 0.000 0.065 3.2 정상 3.2 버림(흐림)
lime_09.jpg 160.2 0.000 0.058 6.1 정상 6.1 버림(흐림)
lime_10.png 62.7 0.174 0.000 67.8 어두움 639.4 고침(밝기)
lime_11.png 228.5 0.000 1.000 39.6 밝음 39.6 버림(밝음)
tangerine_09.jpg 160.6 0.000 0.042 4.8 정상 4.8 버림(흐림)
tangerine_10.png 23.9 1.000 0.000 7.9 아주 어두움 7.9 버림(아주 어두움)
{'그대로': 29, '버림(흐림)': 3, '고침(밝기)': 1, '버림(밝음)': 1, '버림(아주 어두움)': 1}
저장: out_ch16_quality.csv코드 설명
- 1단계는 본문의 손계산을 그대로 옮긴 것입니다. 선명한 줄의 분산 5000 은 흐린 줄 1000 의 5배이고, 표준편차(70.7, 31.6)는 분산의 제곱근입니다.
- 2단계에서 잰 사진은 실습 1의 관문을 통과한 35장입니다. 흐림 점수가 가장 낮은 셋(
apple_09.jpg3.2,tangerine_09.jpg4.8,lime_09.jpg6.1)이 일부러 흐리게 만든 사진입니다. 그다음의 7.9, 39.6, 67.8 은 흐린 사진이 아니라 아주 어둡거나(tangerine_10.png), 하얗게 날아가거나(lime_11.png), 어두운(lime_10.png) 사진입니다. 밝기 차이가 작으면 경계의 값도 작아지기 때문입니다. - 3단계 그래프에서 점수는 67.8 다음에 203.8 로 크게 뛰어오릅니다. 기준값 100 은 이 넓은 틈의 한가운데쯤에 있어, 조금 바꿔도 결과가 흔들리지 않습니다. 세로축을 로그 눈금으로 그려야 3 과 800 을 한 그래프에서 함께 볼 수 있습니다.
- 4단계에서
lime_10.png는 그대로 쟀다면 67.8 로 "흐림"이 되었을 것입니다. 정규화로 밝기를 고친 뒤 다시 재니 639.4 로 올라 남았습니다. 그래서 밝기 판정을 흐림보다 먼저 합니다. 최종 처리는 그대로 29, 버림 5(흐림 3, 밝음 1, 아주 어두움 1), 고침 1 입니다.