16장. AI 데이터 정제와 데이터 증강
데이터 정제란
1장에서 김치찌개를 끓이기 전에 재료를 씻고, 시든 잎을 떼고, 같은 크기로 썬다고 했습니다. 그때는 사진 한 장을 다듬는 이야기였습니다. 이번에는 장바구니 전체입니다. 장 봐 온 재료를 하나씩 꺼내 상한 것은 버리고, 덜 익은 것은 따로 두고, 같은 것을 두 번 산 것은 하나만 씁니다. 데이터 정제는 사진 묶음 전체를 놓고 하는 이 일입니다.
그림의 네 걸음이 정제의 순서입니다. 먼저 파일이 열리는지, 크기와 채널이 어떤지 읽어 봅니다. 다음에 밝기와 흐림을 숫자로 잽니다. 숫자를 보고 버릴지, 고칠지, 그대로 둘지 고릅니다. 마지막으로 남은 사진의 크기와 형식을 맞춥니다. 여기서 재료를 꺼내 살피는 일이 읽어 보기, 상했는지 냄새 맡는 일이 재어 보기, 버리거나 손질하는 일이 고르기, 같은 크기로 써는 일이 맞추기입니다.
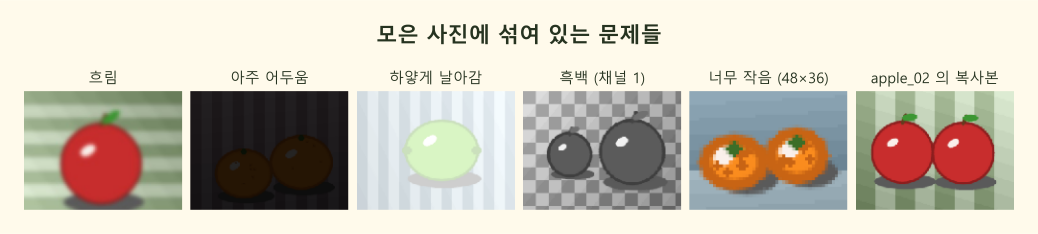
이 장의 실습 폴더 ch16_raw/ 에 섞어 둔 문제 사진 여섯 장입니다. 흐린 사과, 거의 검은 귤, 하얗게 날아간 라임, 흑백으로 저장된 사과, 48×36 으로 아주 작은 귤, 그리고 apple_02.png 를 이름만 바꿔 한 번 더 넣은 복사본입니다. 눈으로 보면 바로 알지만, 사진이 수천 장이면 눈으로 다 볼 수 없습니다. 그래서 문제마다 숫자로 재는 방법을 정합니다.
왼쪽 상자처럼 깨진 파일, 흐린 사진, 중복이 섞인 묶음으로 배우면 모델은 엉뚱한 것을 배웁니다. 흐린 사과가 많으면 "사과는 흐릿하다"를 배우고, 같은 사진이 열 번 들어가면 그 사진 하나를 외웁니다. 이것을 GIGO(Garbage In, Garbage Out, 쓰레기가 들어가면 쓰레기가 나온다)라고 합니다.
이 장에서 찾는 문제와 재는 법
| 문제 | 재는 법 | 처리 | 배우는 절 |
|---|---|---|---|
| 빈 파일, 깨진 파일 | 파일 크기 0, cv2.imread 가 None | 버림 | 깨진 파일과 형식 문제 거르기 |
| 너무 작은 사진 | 짧은 변이 64칸 미만 | 버림 | 깨진 파일과 형식 문제 거르기 |
| 흑백, 투명 채널 | 채널 수 1 또는 4 | 채널 셋으로 고침 | 깨진 파일과 형식 문제 거르기 |
| 너무 어둡거나 밝음 | 평균 밝기, 밝은 칸 비율(4장) | 버림 또는 고침 | 너무 어둡거나 밝은 사진 |
| 흐림 | Laplacian 의 분산 | 버림 | 흐린 사진 찾기 |
| 같은 사진 | MD5, 평균 해시 | 하나만 남김 | 같은 사진 찾기 |
| 크기·형식이 제각각 | 가로·세로, 확장자 | 128×128 png 로 맞춤 | 크기와 형식 맞추기 |
짧은 예시
import os

# ch16_raw 의 파일을 이름순으로 본다. answer.csv 는 정답표라 뺀다
names = sorted(n for n in os.listdir("ch16_raw") if n != "answer.csv")
print(len(names))            # 결과: 38
print(names[:3])             # 결과: ['apple_01.png', 'apple_02.png', 'apple_03.jpg']

# 확장자(점 뒤의 글자)마다 몇 개인지 센다
exts = [os.path.splitext(n)[1] for n in names]
print({e: exts.count(e) for e in sorted(set(exts))})   # 결과: {'.jpg': 7, '.png': 31}
os.path.splitext 는 split extension(확장자 나누기)을 줄인 이름으로, "apple_03.jpg" 를 ("apple_03", ".jpg") 로 나눕니다. 폴더에는 사과 12개, 귤 13개, 라임 13개, 모두 38개의 파일이 있고, 7개가 jpg 입니다.
주의할 점
- 정제는 원본 폴더를 고치지 않습니다. 원본은 그대로 두고, 고른 결과를 새 폴더(
out_ch16_dataset/)에 씁니다. 기준을 바꿔 다시 할 수 있어야 하기 때문입니다. - 버린 파일은 이유와 함께 표로 남깁니다. "왜 이 사진이 빠졌나"를 나중에 확인할 수 있어야 합니다.