16장. AI 데이터 정제와 데이터 증강
실습 3 — 같은 사진 찾기: MD5 와 평균 해시
폴더의 파일마다 MD5 지문을 구해 바이트까지 같은 복사본을 찾고, 평균 해시와 해밍 거리로 다시 저장한 비슷한 사진까지 찾습니다. 서로 다른 사진의 거리는 얼마나 되는지 보고, 기준 5 가 알맞은지 확인합니다.
1단계. MD5 로 바이트까지 같은 파일 찾기
import os
import hashlib
import itertools
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

folder = "ch16_raw"
names = sorted(n for n in os.listdir(folder) if n != "answer.csv")

def md5_of(path):
    """파일을 바이트로 읽어 MD5 지문(32글자)을 돌려준다."""
    with open(path, "rb") as f:                   # rb = read binary
        return hashlib.md5(f.read()).hexdigest()

# 지문 → 그 지문을 가진 파일 이름 목록
groups = {}
for name in names:
    groups.setdefault(md5_of(os.path.join(folder, name)), []).append(name)

print("파일", len(names), "개, 서로 다른 MD5", len(groups), "개")
for digest, members in groups.items():
    if len(members) > 1:
print(f" 같은 지문 {digest[:8]}… : {members}")파일 38 개, 서로 다른 MD5 36 개
같은 지문 51e7f799… : ['apple_02.png', 'apple_10.png']
같은 지문 e9a671bd… : ['lime_04.png', 'lime_13.png']2단계. 평균 해시 만들기
def load_bgr(path):
    """저장된 그대로 읽은 뒤 세 채널로 맞춘다. 못 읽거나 너무 작으면 None."""
    img = cv2.imread(path, cv2.IMREAD_UNCHANGED) if os.path.getsize(path) > 0 else None
    if img is None or min(img.shape[:2]) < 64:
        return None
    if img.ndim == 2:
        return cv2.cvtColor(img, cv2.COLOR_GRAY2BGR)
    if img.shape[2] == 4:
        return cv2.cvtColor(img, cv2.COLOR_BGRA2BGR)
    return img

def ahash(img):
    """8×8 로 줄인 흑백에서 평균보다 밝은 칸을 1 로 적은 64칸 지문."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    # INTER_AREA: 넓이 평균으로 줄여 작은 무늬를 지우고 큰 생김새만 남긴다
    small = cv2.resize(gray, (8, 8), interpolation=cv2.INTER_AREA)
    return (small > small.mean()).astype(np.uint8).flatten()

hashes = {}
for name in names:
    img = load_bgr(os.path.join(folder, name))
    if img is not None:
        hashes[name] = ahash(img)
print("지문을 만든 사진:", len(hashes))

# tangerine_03.png 의 지문을 8줄로 찍어 본다
bits = hashes["tangerine_03.png"].reshape(8, 8)
for line in bits:
print("".join(str(int(v)) for v in line))지문을 만든 사진: 35
00001111
00011111
00011111
01101001
00101111
00001011
00011000
001111113단계. 모든 짝의 해밍 거리 재기
HASH_MAX = 5   # 해밍 거리가 이 값 이하면 같은 사진으로 본다

pairs = []
# itertools.combinations: 목록에서 두 개씩 겹치지 않게 모든 짝을 만든다
for a, b in itertools.combinations(hashes, 2):
    pairs.append({"사진1": a, "사진2": b, "거리": int((hashes[a] != hashes[b]).sum())})
pairs = pd.DataFrame(pairs).sort_values("거리").reset_index(drop=True)

print("짝의 수:", len(pairs))
print(pairs.head(6).to_string(index=False))
same = pairs[pairs["거리"] <= HASH_MAX]
print(f"거리 {HASH_MAX} 이하:", len(same), "짝")
# 같은 사진이 아닌 짝 가운데 가장 가까운 거리: 기준과의 틈을 본다
print("그다음으로 가까운 거리:", int(pairs.loc[pairs["거리"] > HASH_MAX, "거리"].min()))짝의 수: 595
사진1 사진2 거리
apple_02.png apple_10.png 0
tangerine_03.png tangerine_11.jpg 0
lime_04.png lime_13.png 0
tangerine_06.png tangerine_10.png 9
lime_04.png lime_11.png 11
lime_12.png tangerine_01.png 11
거리 5 이하: 3 짝
그다음으로 가까운 거리: 94단계. 같은 사진으로 찾은 짝 띄우기
fig, axes = plt.subplots(len(same), 2, figsize=(6.4, 2.4 * len(same)))
for row, r in enumerate(same.itertuples()):
    for col, name in enumerate([r.사진1, r.사진2]):
        img = load_bgr(os.path.join(folder, name))
        axes[row, col].imshow(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
        # MD5 가 같은지도 제목에 적는다
        same_md5 = md5_of(os.path.join(folder, r.사진1)) == md5_of(os.path.join(folder, r.사진2))
        axes[row, col].set_title(f"{name} (거리 {r.거리}, MD5 {'같음' if same_md5 else '다름'})", fontsize=9)
        axes[row, col].axis("off")
plt.tight_layout()
plt.show()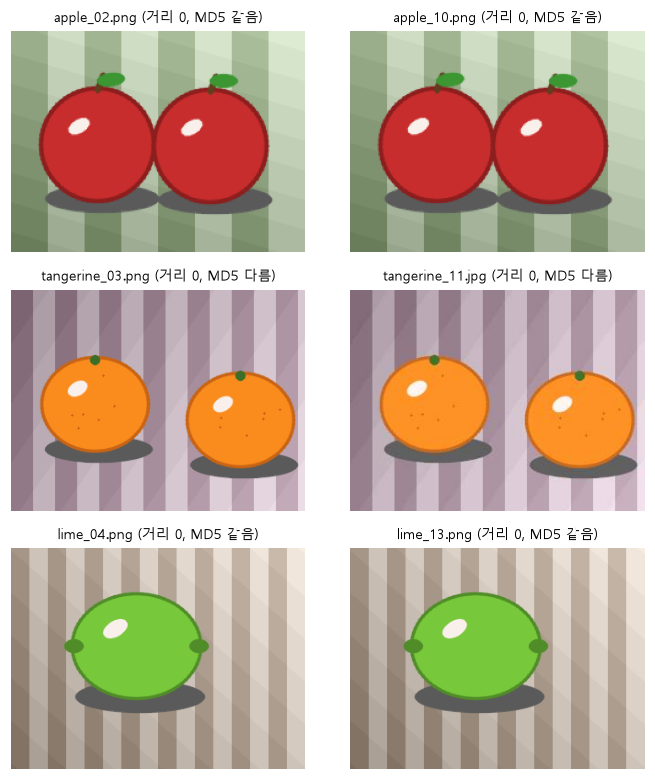
코드 설명
- MD5 로는 38개 파일에서 서로 다른 지문이 36개 나왔습니다. 같은 지문을 가진 묶음은
apple_02.png·apple_10.png와lime_04.png·lime_13.png두 쌍으로, 이름만 바꾼 복사본입니다. 빈 파일과 깨진 파일도 지문은 만들어지지만 서로 달라서 묶이지 않습니다. - 2단계에서
tangerine_03.png의 지문을 8줄로 찍으면 왼쪽이 0, 오른쪽이 1 로 많습니다. 사진의 오른쪽이 더 밝다는 뜻입니다. 지문은 "어디가 밝고 어디가 어두운가"라는 큰 생김새만 남깁니다. - 3단계에서 35장의 짝 595개 가운데 거리가 0 인 짝이 셋입니다. MD5 가 찾은 두 쌍에 더해, MD5 로는 못 찾은
tangerine_03.png·tangerine_11.jpg가 나왔습니다. 조금 밝게 해서 jpg 로 다시 저장해도 지문이 하나도 바뀌지 않았습니다. - 서로 다른 사진 가운데 가장 가까운 짝은 거리 9(
tangerine_06.png와 거의 검은tangerine_10.png)였습니다. 기준 5 와 9 사이에 틈이 있어 이 묶음에서는 5 가 알맞습니다. 바탕이 비슷한 사진이 많은 데이터라면 이 틈이 좁아지므로, 기준을 정하기 전에 이렇게 가장 가까운 거리를 먼저 봅니다.