16장. AI 데이터 정제와 데이터 증강
프로젝트 1 — 학습용 묶음 만들기: 정제 → 크기 통일 → 증강
강사가 다음 수업에서 "과일 분류 모델"을 학습시켜 보려고, 수강생들이 찍어 보낸 과일 사진을 한 폴더(ch16_raw/)에 모았습니다. 그런데 열어 보니 열리지 않는 파일, 흐린 사진, 같은 사진, 크기가 제각각인 사진이 섞여 있습니다. 버릴 사진을 이유와 함께 골라내고, 남은 사진을 128×128 png 로 맞춘 뒤, 학습용만 증강해서 out_ch16_dataset/ 에 학습용 묶음을 만들어 보세요. 사진은 모두 OpenCV 로 그린 가상의 과일 사진이고, 수강생이 보냈다는 상황은 연습을 위해 지어낸 것입니다.
| 파일 | 내용 |
|---|---|
ch16_raw/apple_*.png, *.jpg | 사과 사진 12개 |
ch16_raw/tangerine_*.png, *.jpg | 귤 사진 13개 |
ch16_raw/lime_*.png, *.jpg | 라임 사진 13개 |
ch16_raw/answer.csv | 정답표: 파일마다 클래스, 문제, 처리(그대로·고침·버림), 같은 사진 |
정답표는 채점용입니다. 거르는 코드에서는 쓰지 말고, 다 거른 뒤 맞았는지 견줄 때만 씁니다.
요구사항
- 실습 1의 관문(빈 파일, 깨짐, 짧은 변 64 미만)으로 거르고, 흑백·투명 채널 그림은 세 채널로 맞춥니다.
- 이 장의 밝기 판정표로 아주 어두운 사진과 밝은 사진을 버리고, 어두운 사진은 정규화로 고칩니다. 그 뒤 흐림 점수가 100 미만인 사진을 버립니다.
- MD5 가 같거나 평균 해시의 해밍 거리가 5 이하인 사진은 이름순으로 앞의 것 하나만 남깁니다.
- 버린 파일을 파일, 이유 두 칸의 표로 찍고
out_ch16_removed.csv로 저장합니다. 정답표와 견주어 처리(버림·고침·그대로)를 몇 개 맞혔는지 찍습니다. - 남은 사진을 레터박스로 128×128 에 맞추고, 클래스마다 씨앗 1620 으로 섞어 2장을 시험용으로 뗍니다.
- 학습용 사진만 한 장에 증강 3장씩(씨앗 1630) 더해,
out_ch16_dataset/train/클래스/,out_ch16_dataset/test/클래스/에클래스_번호.png꼴로 저장합니다. - 클래스마다 원본, 정제 후, 학습용, 시험용, 증강 후 학습용의 개수를 표로 찍고, 클래스마다 학습용 몇 장을 모은 미리보기 격자를
out_ch16_preview.png로 저장합니다.
힌트
- 실습 1의
check_file, 실습 2의blur_score·exposure, 실습 3의md5_of·ahash, 실습 5의augment, 본문의letterbox를 그대로 가져옵니다. - 거르는 단계마다
removed.append({"파일": name, "이유": "..."})처럼 이유를 남기고, 남은 사진은 사전kept[name] = img에 담아 다음 단계로 넘깁니다. - 중복은 이름순으로 돌면서, 이미 남긴 사진들과 견줘 같은 것이 있으면 버립니다. 그러면 앞의 것이 남습니다.
- 시험용은
rng.permutation(목록)으로 섞은 뒤 앞의 2장을 고릅니다. permutation 은 "순서 바꾸기"라는 뜻입니다. - 다시 돌렸을 때 전에 만든 파일이 남지 않도록, 시작할 때
shutil.rmtree("out_ch16_dataset", ignore_errors=True)로 결과 폴더를 지웁니다. rmtree 는 remove tree(폴더를 통째로 지우기)입니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 점검과 채널 | 빈 파일·깨짐·작음을 버리고 흑백·투명 채널을 세 채널로 맞춘다 | 15 |
| 밝기와 흐림 | 판정표대로 버리고 고치며, 고친 뒤 흐림 점수를 잰다 | 20 |
| 중복 | MD5 와 평균 해시로 찾고 앞의 것만 남긴다 | 15 |
| 기록과 대조 | 버린 이유 표를 저장하고 정답표와 견준 결과를 찍는다 | 15 |
| 맞추기와 나누기 | 128×128 레터박스, 클래스마다 시험용 2장, 시험용은 증강하지 않는다 | 20 |
| 저장과 요약 | 이름 규칙대로 저장하고 개수 표와 미리보기를 만든다 | 15 |
코드의 흐름
그림의 다섯 단계를 예시 풀이의 단계와 같은 순서로 짰습니다. 둘째 단계 안에서도 밝기를 먼저 고친 뒤 흐림을 재고, 흐림을 거른 뒤에 중복을 찾습니다. 넷째 단계의 나누기가 다섯째 단계의 늘리기보다 앞에 있는 것이 중요합니다. 늘린 사진이 시험용에 섞이지 않게 하기 위해서입니다.
실제 데이터로 해 보려면
실제 사진으로 해 보려면 folder 와 클래스 이름만 바꾸면 됩니다. 공개 데이터로 연습하려면 AI Hub(aihub.or.kr)처럼 농산물, 제조 부품 같은 이미지 데이터를 공개한 곳에서 내려받습니다. 내려받기 전에 데이터마다 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 사람의 얼굴이나 차량 번호가 찍힌 사진은 개인정보 처리 기준을 먼저 확인합니다. 실제 사진은 크기와 무늬가 훨씬 다양하므로, 흐림 점수와 해밍 거리의 기준값은 실습 2·3처럼 분포를 먼저 그려 본 뒤 정합니다. 사진이 수천 장이면 17장에서 다룰 일괄 처리 방식으로 바꿉니다.
결과 보기 (예시 풀이)
1단계. 점검하고 채널 맞추기
import os
import shutil
import hashlib
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

folder = "ch16_raw"
CLASSES = ["apple", "tangerine", "lime"]
names = sorted(n for n in os.listdir(folder) if n != "answer.csv")
removed, kept, fixed = [], {}, []

# 요구사항 1: 실습 1의 관문
for name in names:
    path = os.path.join(folder, name)
    if os.path.getsize(path) == 0:
        removed.append({"파일": name, "이유": "빈 파일"})
        continue
    img = cv2.imread(path, cv2.IMREAD_UNCHANGED)
    if img is None:
        removed.append({"파일": name, "이유": "깨짐"})
        continue
    if min(img.shape[:2]) < 64:
        removed.append({"파일": name, "이유": "너무 작음"})
        continue
    if img.ndim == 2:                                  # 흑백 → 세 채널
        img = cv2.cvtColor(img, cv2.COLOR_GRAY2BGR)
        fixed.append(name)
    elif img.shape[2] == 4:                            # 투명 채널 → 세 채널
        img = cv2.cvtColor(img, cv2.COLOR_BGRA2BGR)
        fixed.append(name)
    kept[name] = img

print("1단계 뒤 남은 사진:", len(kept), "/ 버린 파일:", [r["파일"] for r in removed])
print("채널을 맞춘 사진:", fixed)1단계 뒤 남은 사진: 35 / 버린 파일: ['apple_11.png', 'tangerine_12.png', 'tangerine_13.png']
채널을 맞춘 사진: ['apple_12.png', 'lime_12.png']2단계. 밝기와 흐림으로 거르기
def blur_score(img):
    """흑백 Laplacian 의 분산. 클수록 선명하다."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    return float(cv2.Laplacian(gray, cv2.CV_64F).var())

def exposure(gray):
    """이 장의 밝기 판정표."""
    mean, bright = float(gray.mean()), float((gray > 205).mean())
    if mean < 40:
        return "아주 어두움"
    if mean < 80 or float((gray < 50).mean()) > 0.4:
        return "어두움"
    if mean > 175 or bright > 0.4:
        return "밝음"
    return "정상"

# 요구사항 2: 밝기 판정 → (고친 뒤) 흐림 점수
for name in list(kept):                                # 돌면서 지우므로 이름 목록을 복사해 돈다
    img = kept[name]
    label = exposure(cv2.cvtColor(img, cv2.COLOR_BGR2GRAY))
    if label in ("아주 어두움", "밝음"):
        removed.append({"파일": name, "이유": label})
        del kept[name]
        continue
    if label == "어두움":
        img = cv2.normalize(img, None, 0, 255, cv2.NORM_MINMAX)   # 5차시의 정규화
        kept[name] = img
        fixed.append(name)
    score = blur_score(img)
    if score < 100:
        removed.append({"파일": name, "이유": f"흐림({score:.1f})"})
        del kept[name]

print("2단계 뒤 남은 사진:", len(kept))
print(pd.DataFrame(removed).to_string(index=False))2단계 뒤 남은 사진: 30
파일 이유
apple_11.png 깨짐
tangerine_12.png 너무 작음
tangerine_13.png 빈 파일
apple_09.jpg 흐림(3.2)
lime_09.jpg 흐림(6.1)
lime_11.png 밝음
tangerine_09.jpg 흐림(4.8)
tangerine_10.png 아주 어두움3단계. 중복 거르기
def md5_of(path):
    with open(path, "rb") as f:
        return hashlib.md5(f.read()).hexdigest()

def ahash(img):
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    small = cv2.resize(gray, (8, 8), interpolation=cv2.INTER_AREA)
    return (small > small.mean()).flatten()

# 요구사항 3: 이름순으로 돌며, 이미 남긴 사진과 같으면 버린다(앞의 것이 남는다)
seen = []                                              # (이름, MD5, 평균 해시)
for name in sorted(kept):
    digest, bits = md5_of(os.path.join(folder, name)), ahash(kept[name])
    twin = None
    for other, other_digest, other_bits in seen:
        if digest == other_digest:
            twin = (other, "MD5 같음")
            break
        if int((bits != other_bits).sum()) <= 5:
            twin = (other, f"해시 거리 {int((bits != other_bits).sum())}")
            break
    if twin:
        removed.append({"파일": name, "이유": f"중복({twin[0]}, {twin[1]})"})
        del kept[name]
    else:
        seen.append((name, digest, bits))

print("3단계 뒤 남은 사진:", len(kept))
for r in removed[-3:]:
print(" ", r["파일"], "→", r["이유"])3단계 뒤 남은 사진: 27
apple_10.png → 중복(apple_02.png, MD5 같음)
lime_13.png → 중복(lime_04.png, MD5 같음)
tangerine_11.jpg → 중복(tangerine_03.png, 해시 거리 0)4단계. 버린 이유를 저장하고 정답표와 견주기
# 요구사항 4: 버린 이유 표
removed_df = pd.DataFrame(removed).sort_values("파일").reset_index(drop=True)
removed_df.to_csv("out_ch16_removed.csv", index=False, encoding="utf-8-sig")
print(removed_df.to_string(index=False))
print("저장: out_ch16_removed.csv")

# 내 처리: 버린 파일은 버림, 채널·밝기를 고친 파일은 고침, 나머지는 그대로
mine = {n: "그대로" for n in names}
mine.update({n: "고침" for n in fixed if n in kept})
mine.update({r["파일"]: "버림" for r in removed})

answer = pd.read_csv(os.path.join(folder, "answer.csv"))
answer["내처리"] = answer["파일"].map(mine)
hit = int((answer["처리"] == answer["내처리"]).sum())
print(f"정답표와 같은 처리: {hit} / {len(answer)}")
wrong = answer[answer["처리"] != answer["내처리"]]
print("다른 곳:", "없음" if wrong.empty else wrong[["파일", "처리", "내처리"]].to_string(index=False)) 파일 이유
apple_09.jpg 흐림(3.2)
apple_10.png 중복(apple_02.png, MD5 같음)
apple_11.png 깨짐
lime_09.jpg 흐림(6.1)
lime_11.png 밝음
lime_13.png 중복(lime_04.png, MD5 같음)
tangerine_09.jpg 흐림(4.8)
tangerine_10.png 아주 어두움
tangerine_11.jpg 중복(tangerine_03.png, 해시 거리 0)
tangerine_12.png 너무 작음
tangerine_13.png 빈 파일
저장: out_ch16_removed.csv
정답표와 같은 처리: 38 / 38
다른 곳: 없음5단계. 크기를 맞추고 시험용 떼기
GRAY = (128, 128, 128)

def letterbox(img, size=128, color=GRAY):
    """긴 변을 size 에 맞춰 줄이고 모자란 칸을 회색으로 덧댄다(14차시)."""
    h, w = img.shape[:2]
    scale = size / max(h, w)
    nw, nh = round(w * scale), round(h * scale)
    small = cv2.resize(img, (nw, nh), interpolation=cv2.INTER_AREA)
    top, left = (size - nh) // 2, (size - nw) // 2
    return cv2.copyMakeBorder(small, top, size - nh - top, left, size - nw - left,
                              cv2.BORDER_CONSTANT, value=color)

# 요구사항 5: 128×128 로 맞춘 뒤, 클래스마다 씨앗 1620 으로 섞어 2장을 시험용으로
boxed = {name: letterbox(img) for name, img in kept.items()}
split_rng = np.random.default_rng(1620)
train, test = {}, {}
for cls in CLASSES:
    members = sorted(n for n in boxed if n.startswith(cls + "_"))
    order = split_rng.permutation(members)             # 순서를 섞은 새 목록
    test[cls] = sorted(order[:2].tolist())
    train[cls] = sorted(order[2:].tolist())
    print(f"{cls:9} 남은 {len(members)}장 → 학습용 {len(train[cls])}, 시험용 {test[cls]}")
print("크기:", {img.shape for img in boxed.values()})apple 남은 9장 → 학습용 7, 시험용 ['apple_07.png', 'apple_08.png']
tangerine 남은 8장 → 학습용 6, 시험용 ['tangerine_04.png', 'tangerine_07.png']
lime 남은 10장 → 학습용 8, 시험용 ['lime_06.png', 'lime_07.jpg']
크기: {(128, 128, 3)}6단계. 학습용만 증강해서 저장하기
def augment(img, rng):
    """실습 5와 같은 랜덤 증강."""
    out = img.copy()
    h, w = out.shape[:2]
    if rng.random() < 0.5:
        out = cv2.flip(out, 1)
    if rng.random() < 0.7:
        M = cv2.getRotationMatrix2D((w / 2, h / 2), rng.uniform(-15, 15), 1.0)
        out = cv2.warpAffine(out, M, (w, h), borderMode=cv2.BORDER_REFLECT)
    if rng.random() < 0.5:
        s = rng.uniform(0.8, 0.95)
        ch, cw = int(h * s), int(w * s)
        y0, x0 = int(rng.integers(0, h - ch + 1)), int(rng.integers(0, w - cw + 1))
        out = cv2.resize(out[y0:y0 + ch, x0:x0 + cw], (w, h), interpolation=cv2.INTER_LINEAR)
    if rng.random() < 0.7:
        out = np.clip(out.astype(np.float32) * rng.uniform(0.8, 1.2) + rng.uniform(-30, 30), 0, 255).astype(np.uint8)
    if rng.random() < 0.3:
        hsv = cv2.cvtColor(out, cv2.COLOR_BGR2HSV)
        hsv[:, :, 0] = (hsv[:, :, 0].astype(np.int32) + int(rng.integers(-3, 4))) % 180
        out = cv2.cvtColor(hsv, cv2.COLOR_HSV2BGR)
    if rng.random() < 0.2:
        out = cv2.GaussianBlur(out, (3, 3), 0)
    if rng.random() < 0.2:
        out = np.clip(out.astype(np.float64) + rng.normal(0, rng.uniform(5, 12), out.shape), 0, 255).astype(np.uint8)
    return out

# 다시 돌려도 전의 파일이 남지 않게 결과 폴더를 지우고 시작한다
root = "out_ch16_dataset"
shutil.rmtree(root, ignore_errors=True)
aug_rng = np.random.default_rng(1630)
saved = {}
for cls in CLASSES:
    for part in ("train", "test"):
        os.makedirs(os.path.join(root, part, cls), exist_ok=True)   # makedirs: 중간 폴더까지 만든다
    # 시험용: 그대로 저장
    for k, name in enumerate(test[cls], start=1):
        cv2.imwrite(os.path.join(root, "test", cls, f"{cls}_{k:03d}.png"), boxed[name])
    # 학습용: 원본 한 장 + 증강 세 장
    k = 0
    for name in train[cls]:
        for copy in range(4):
            k += 1
            img = boxed[name] if copy == 0 else augment(boxed[name], aug_rng)
            cv2.imwrite(os.path.join(root, "train", cls, f"{cls}_{k:03d}.png"), img)
    saved[cls] = k
print("학습용 저장:", saved)
print("예:", sorted(os.listdir(os.path.join(root, "train", "apple")))[:5])학습용 저장: {'apple': 28, 'tangerine': 24, 'lime': 32}
예: ['apple_001.png', 'apple_002.png', 'apple_003.png', 'apple_004.png', 'apple_005.png']7단계. 개수 표와 미리보기
# 요구사항 7: 클래스마다 개수
rows = []
for cls in CLASSES:
    rows.append({
        "클래스": cls,
        "원본": sum(n.startswith(cls + "_") for n in names),
        "정제후": sum(n.startswith(cls + "_") for n in kept),
        "학습용": len(train[cls]),
        "시험용": len(os.listdir(os.path.join(root, "test", cls))),
        "증강후학습용": len(os.listdir(os.path.join(root, "train", cls))),
    })
counts = pd.DataFrame(rows)
counts.loc[len(counts)] = ["합계"] + [int(counts[c].sum()) for c in counts.columns[1:]]
print(counts.to_string(index=False))

# 클래스마다 학습용 앞의 8장(원본 2장과 그 증강 6장)을 한 줄로
fig, axes = plt.subplots(3, 8, figsize=(12, 4.8))
for row, cls in enumerate(CLASSES):
    files = sorted(os.listdir(os.path.join(root, "train", cls)))[:8]
    for col, file in enumerate(files):
        img = cv2.imread(os.path.join(root, "train", cls, file))
        axes[row, col].imshow(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
        axes[row, col].set_title(file, fontsize=8)
        axes[row, col].axis("off")
plt.tight_layout()
plt.savefig("out_ch16_preview.png", dpi=80)
print("저장: out_ch16_preview.png")
plt.show() 클래스 원본 정제후 학습용 시험용 증강후학습용
apple 12 9 7 2 28
tangerine 13 8 6 2 24
lime 13 10 8 2 32
합계 38 27 21 6 84
저장: out_ch16_preview.png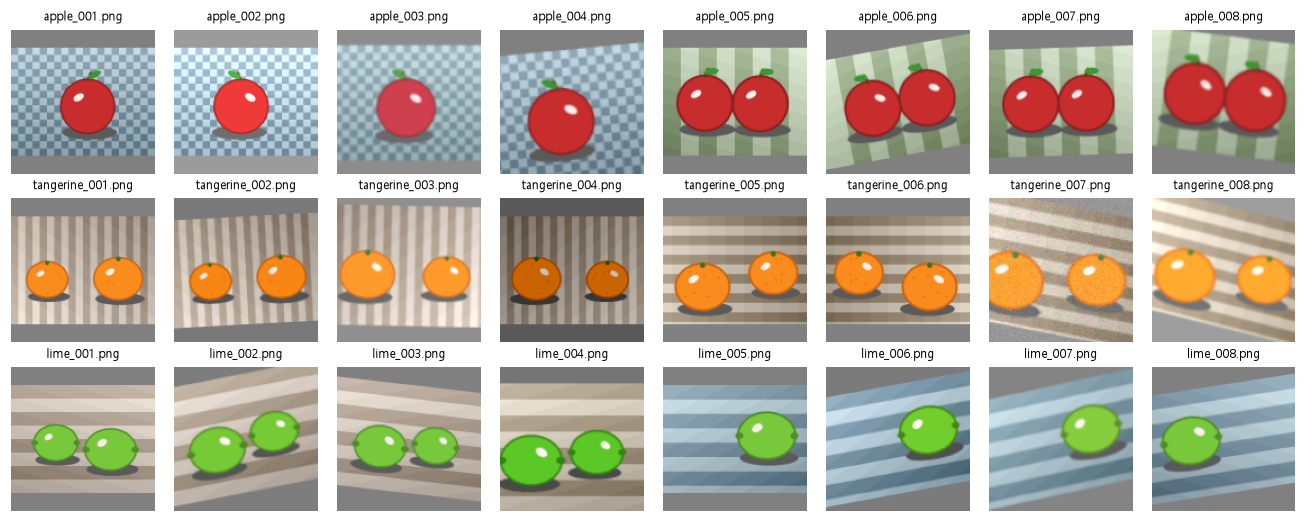
버린 파일은 11개입니다. 1단계에서 깨진 파일, 너무 작은 파일, 빈 파일 3개를, 2단계에서 흐린 사진 3개(흐림 점수 3.2, 4.8, 6.1)와 밝은 사진, 아주 어두운 사진 2개를, 3단계에서 중복 3개를 버렸습니다. 중복 가운데 apple_10.png 와 lime_13.png 는 MD5 가 같았고, tangerine_11.jpg 는 MD5 는 달랐지만 평균 해시의 거리가 0 이라 찾았습니다. 흑백 apple_12.png 와 투명 채널 lime_12.png 는 채널을 맞추고, 어두운 lime_10.png 는 정규화로 고쳐 남겼습니다. 이렇게 정한 처리를 정답표와 견주니 38개 모두 같았습니다. 남은 27장(사과 9, 귤 8, 라임 10)을 128×128 로 맞추고 클래스마다 2장씩 시험용 6장을 뗐고, 학습용 21장에 한 장마다 증강 3장을 더해 학습용이 84장(사과 28, 귤 24, 라임 32)이 되었습니다. 시험용 6장은 증강하지 않았습니다. 미리보기에서는 회전한 사진의 위아래에 레터박스의 회색 여백이 비스듬히 비쳐 들어간 것이 보입니다. 여백 색이 모든 사진에 같으므로 큰 문제는 아니지만, 여백이 신경 쓰이면 레터박스 전에 증강하는 순서도 생각해 볼 수 있습니다. 사과와 라임의 학습용 수가 28 과 32 로 다른 것은 정제 뒤 남은 수가 달랐기 때문입니다. 클래스마다 수를 맞추고 싶으면 적은 클래스에 증강을 더 겁니다. 폴더가 늘어나고 사진이 수천 장이 되면 이 흐름을 17장의 일괄 처리 도구로 다듬습니다.