18장. OpenCV 전처리와 YOLO 연계
실습 2 — 부품 데이터셋으로 전이 학습
17장에서 만든 out_ch17_yolo/ 로 yolo11n.pt 를 30 에포크 더 가르칩니다. 학습이 끝나면 out_ch18_runs/parts/ 에 가중치와 기록이 남고, 기록 results.csv 를 pandas 로 읽어 손실과 mAP50 의 흐름을 그래프로 봅니다. 17장 실습 5를 먼저 실행해야 하고, 교안 PC(그래픽 카드 없음)에서 학습에 6분 남짓 걸렸습니다. 뒤의 실습 3, 4, 5와 프로젝트, 그리고 19장부터 20장까지의 실습이 여기서 만든 best.pt 를 씁니다.
1단계. 데이터셋 확인하기
from pathlib import Path

root = Path("out_ch17_yolo")
if not (root / "data.yaml").exists():
    raise SystemExit("out_ch17_yolo 가 없습니다. 17차시 실습 5를 먼저 실행하세요")

# data.yaml 을 그대로 찍어 학습이 읽을 안내판을 확인한다
print((root / "data.yaml").read_text(encoding="utf-8"), end="")
# 그림과 라벨 수가 맞는지 본다
for part in ("train", "val"):
    n_img = len(list((root / "images" / part).glob("*.png")))
    n_lab = len(list((root / "labels" / part).glob("*.txt")))
    n_obj = sum(len([l for l in p.read_text(encoding="utf-8").split("\n") if l.strip()])
                for p in (root / "labels" / part).glob("*.txt"))
print(f"{part}: 그림 {n_img}장 · 라벨 {n_lab}개 · 물체 {n_obj}개")path: out_ch17_yolo
train: images/train
val: images/val
names:
0: bolt
1: nut
2: washer
train: 그림 45장 · 라벨 45개 · 물체 146개
val: 그림 11장 · 라벨 11개 · 물체 26개2단계. 학습하기
import os
import time
os.environ["YOLO_VERBOSE"] = "False"
from ultralytics import YOLO

model = YOLO("yolo11n.pt")                  # COCO 로 미리 배운 가중치에서 시작한다
start = time.perf_counter()
model.train(data="out_ch17_yolo/data.yaml",   # 17차시의 데이터셋 안내판
            epochs=30,                        # 학습용 사진 전체를 30번 본다
            imgsz=320,                        # 사진을 320 에 맞춘다
            batch=8,                          # 한 번에 8장씩
            device="cpu",                     # CPU 로 계산
            workers=0,                        # 사진 읽는 일꾼을 따로 두지 않는다(Windows 에서 안전)
            seed=0,                           # 씨앗 고정
            deterministic=True,               # 같은 순서로 계산해 다시 돌려도 같게
            project=os.path.abspath("out_ch18_runs"),   # 결과를 둘 폴더. 꼭 절대 경로로
            name="parts",                     # 그 안의 하위 폴더 이름
            exist_ok=True,                    # 이미 있으면 덮어쓴다
            plots=False,                      # 그림 파일은 만들지 않는다(그래프는 4단계에서 직접)
            verbose=False)                    # 긴 진행 글을 줄인다
minutes = (time.perf_counter() - start) / 60
print("학습 시간(분):", round(minutes, 1), "· 컴퓨터마다 다르다")

run = Path("out_ch18_runs/parts")
print("best.pt 가 있는가:", (run / "weights" / "best.pt").exists())
print("last.pt 가 있는가:", (run / "weights" / "last.pt").exists())학습 시간(분): 5.7 · 컴퓨터마다 다르다
best.pt 가 있는가: True
last.pt 가 있는가: True3단계. 학습 기록 읽기
import pandas as pd

hist = pd.read_csv("out_ch18_runs/parts/results.csv")
hist.columns = hist.columns.str.strip()       # 열 이름 앞뒤의 빈칸을 없앤다
print("기록 줄 수:", len(hist))
cols = ["epoch", "train/box_loss", "train/cls_loss", "val/box_loss",
        "metrics/precision(B)", "metrics/recall(B)", "metrics/mAP50(B)", "metrics/mAP50-95(B)"]
# 처음, 가운데, 마지막 에포크만 골라 소수 셋째 자리로 찍는다
print(hist.loc[[0, 14, len(hist) - 1], cols].round(3).to_string(index=False))

best = hist.loc[hist["metrics/mAP50(B)"].idxmax()]
print("mAP50 이 가장 높았던 에포크:", int(best["epoch"]), "· 값:", round(float(best["metrics/mAP50(B)"]), 3))기록 줄 수: 30
epoch train/box_loss train/cls_loss val/box_loss metrics/precision(B) metrics/recall(B) metrics/mAP50(B) metrics/mAP50-95(B)
1 1.152 2.945 0.587 0.690 0.609 0.564 0.472
15 0.615 0.597 0.456 0.986 1.000 0.995 0.902
30 0.330 0.385 0.272 0.991 1.000 0.995 0.955
mAP50 이 가장 높았던 에포크: 12 · 값: 0.9954단계. 손실과 mAP50 그래프
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

fig, axes = plt.subplots(1, 2, figsize=(11, 4), layout="constrained")
# 왼쪽: 손실. 작을수록 좋다
axes[0].plot(hist["epoch"], hist["train/box_loss"], label="학습용 상자 손실")
axes[0].plot(hist["epoch"], hist["train/cls_loss"], label="학습용 클래스 손실")
axes[0].plot(hist["epoch"], hist["val/box_loss"], label="검증용 상자 손실")
axes[0].set_title("손실 (작을수록 좋다)")
axes[0].set_xlabel("에포크")
axes[0].legend()
# 오른쪽: 검증용 사진의 점수. 1 에 가까울수록 좋다
axes[1].plot(hist["epoch"], hist["metrics/mAP50(B)"], label="mAP50")
axes[1].plot(hist["epoch"], hist["metrics/mAP50-95(B)"], label="mAP50-95")
axes[1].set_ylim(0, 1.05)
axes[1].set_title("검증용 점수 (1 에 가까울수록 좋다)")
axes[1].set_xlabel("에포크")
axes[1].legend(loc="lower right")
plt.show()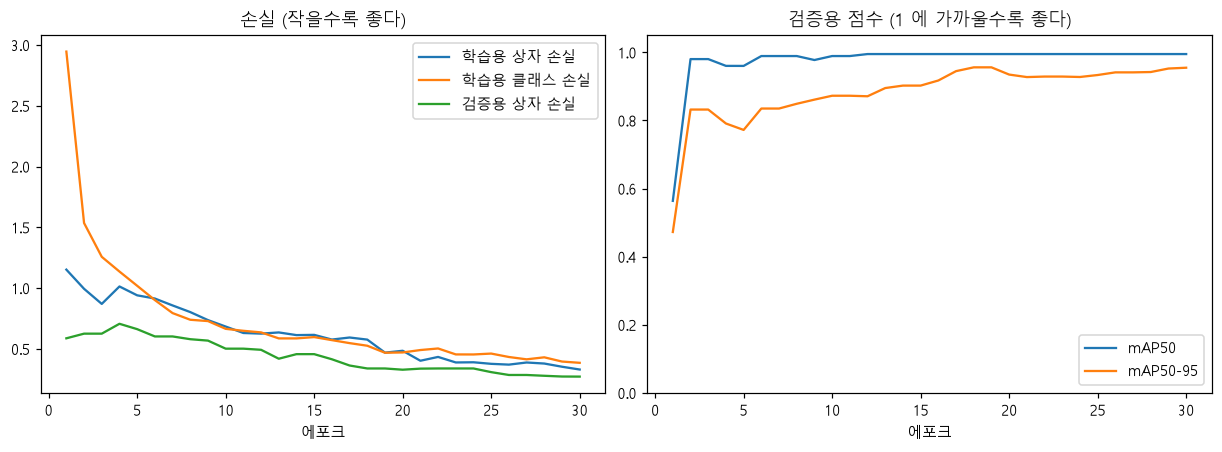
학습은 교안 PC 에서 5.7분 걸렸습니다(에포크 한 번에 11초쯤, 컴퓨터마다 다릅니다). 왼쪽 그래프에서 학습용 클래스 손실은 2.945 에서 0.385 로, 상자 손실은 1.152 에서 0.330 으로 줄었고, 검증용 상자 손실도 0.587 에서 0.272 로 줄었습니다. 검증용 손실이 끝까지 다시 오르지 않았으므로 30 에포크 안에서는 과적합의 낌새가 보이지 않습니다. 오른쪽 그래프의 mAP50 은 첫 에포크 0.564 에서 둘째 에포크에 0.98 가까이 뛰어오르고, 12번째 에포크부터 0.995 로 평평해졌습니다. 더 엄격한 mAP50-95 는 그 뒤에도 조금씩 올라 마지막에 0.955 입니다. 사전학습 가중치에서 시작했기 때문에 부품 45장으로도 몇 에포크 만에 점수가 올랐습니다. 다만 검증용 사진이 11장뿐이고 단순한 가상 그림이라 점수가 아주 높게 나온 것입니다. 실제 사진에서도 이만큼 나온다고 보면 안 됩니다.
코드 설명
model.train(...)한 줄이 그림의 네 걸음(문제 풀기, 채점, 고치기, 모의고사)을 30 에포크 되풀이합니다. 값의 뜻은 "전이 학습" 절의 표에 있습니다.project를 상대 경로로 주면 ultralytics 8.4 는runs/detect/아래에 폴더를 만듭니다.os.path.abspath("out_ch18_runs")처럼 절대 경로로 줘야data/out_ch18_runs/parts/에 남습니다.hist.columns.str.strip()은 열 이름 앞뒤의 빈칸을 없앱니다. ultralytics 판에 따라 열 이름에 빈칸이 붙어 있어hist["epoch"]가 안 될 수 있습니다.best.pt는 mAP 점수가 가장 좋았던 때의 가중치,last.pt는 마지막 에포크의 가중치입니다. 뒤 실습은best.pt를 씁니다.idxmax는 가장 큰 값이 처음 나온 줄을 고르므로 12번째 에포크(0.995)가 나왔습니다. 그 뒤로도 0.995 가 이어졌으니, 이렇게 값이 평평할 때는 mAP50-95(마지막 0.955)처럼 더 엄격한 점수를 함께 봅니다.