18장. OpenCV 전처리와 YOLO 연계
실습 1 — 사전학습 모델로 첫 추론
COCO 로 미리 배운 yolo11n.pt 를 불러와 1장의 과일 진열대 그림 fruit_stand.png 에서 물체를 찾습니다. 결과에서 상자, 신뢰도, 클래스를 꺼내 표로 찍고, OpenCV 로 직접 그립니다. data/yolo11n.pt 가 있어야 하고, 없으면 처음 실행할 때 인터넷에서 받습니다.
1단계. 모델 불러오고 클래스 이름 보기
import os
# 불러오기 전에 둔다: ultralytics 의 긴 진행 글을 줄인다
os.environ["YOLO_VERBOSE"] = "False"
from ultralytics import YOLO
import cv2
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

# 사전학습 가중치를 불러온다(data 폴더의 yolo11n.pt)
model = YOLO("yolo11n.pt")
# names: 클래스 번호 → 이름 사전. COCO 의 80가지가 들어 있다
print("클래스 수:", len(model.names))
print("앞의 다섯:", [model.names[k] for k in range(5)])
# 과일 이름의 번호를 찾아 둔다. lime(라임)은 COCO 에 없다
fruits = {name: k for k, name in model.names.items() if name in ("apple", "orange", "banana", "lime")}
print("과일 번호:", fruits)클래스 수: 80
앞의 다섯: ['person', 'bicycle', 'car', 'motorcycle', 'airplane']
과일 번호: {'banana': 46, 'apple': 47, 'orange': 49}2단계. 과일 진열대에서 물체 찾기
img = cv2.imread("fruit_stand.png")
print("그림 크기:", img.shape)

# predict: 추론. imgsz=320 은 긴 쪽을 320 에 맞춰 넣는 크기, conf=0.25 는 신뢰도 기준값
results = model.predict(img,
                        imgsz=320,          # 넣는 크기
                        conf=0.25,          # 이보다 자신 없는 상자는 버린다
                        device="cpu",       # CPU 로 계산
                        verbose=False)      # 진행 글을 찍지 않는다
r = results[0]                              # 그림 한 장을 넣었으니 결과도 하나

# 결과를 NumPy 배열로 꺼낸다. .cpu() 는 계산 장치에서 꺼내 오는 일
xyxy = r.boxes.xyxy.cpu().numpy()
conf = r.boxes.conf.cpu().numpy()
cls = r.boxes.cls.cpu().numpy().astype(int)
print("찾은 물체 수:", len(xyxy))
for box, p, c in zip(xyxy, conf, cls):
    x1, y1, x2, y2 = [int(v) for v in box]
print(f"{r.names[int(c)]:12} 신뢰도 {float(p):.2f} 상자 ({x1}, {y1}, {x2}, {y2})")그림 크기: (240, 320, 3)
찾은 물체 수: 03단계. OpenCV 로 상자와 이름 그리기
drawn = img.copy()                          # 원본은 그대로 두고 사본에 그린다
for box, p, c in zip(xyxy, conf, cls):
    x1, y1, x2, y2 = [int(v) for v in box]
    cv2.rectangle(drawn, (x1, y1), (x2, y2), (255, 255, 255), 2)     # 흰 상자
    label = f"{r.names[int(c)]} {float(p):.2f}"
    # 글자 뒤에 검은 띠를 깔아 어느 바탕에서도 읽히게 한다. getTextSize: 글자가 차지할 크기
    (tw, th), _ = cv2.getTextSize(label, cv2.FONT_HERSHEY_SIMPLEX, 0.45, 1)
    ty = max(y1, th + 4)
    cv2.rectangle(drawn, (x1, ty - th - 4), (x1 + tw + 2, ty), (0, 0, 0), -1)   # -1: 속을 채운다
    cv2.putText(drawn, label, (x1 + 1, ty - 3), cv2.FONT_HERSHEY_SIMPLEX, 0.45, (255, 255, 255), 1)

# 클래스별로 몇 개 찾았는지 센다
counts = {}
for c in cls:
    counts[r.names[int(c)]] = counts.get(r.names[int(c)], 0) + 1
print("클래스별 개수:", counts)

fig, axes = plt.subplots(1, 2, figsize=(11, 4.2), layout="constrained")
axes[0].imshow(cv2.cvtColor(img, cv2.COLOR_BGR2RGB))
axes[0].set_title("fruit_stand.png 원본")
axes[1].imshow(cv2.cvtColor(drawn, cv2.COLOR_BGR2RGB))
axes[1].set_title(f"yolo11n 이 찾은 물체 {len(xyxy)}개 (conf 0.25 이상)")
for ax in axes:
    ax.axis("off")
plt.show()클래스별 개수: {}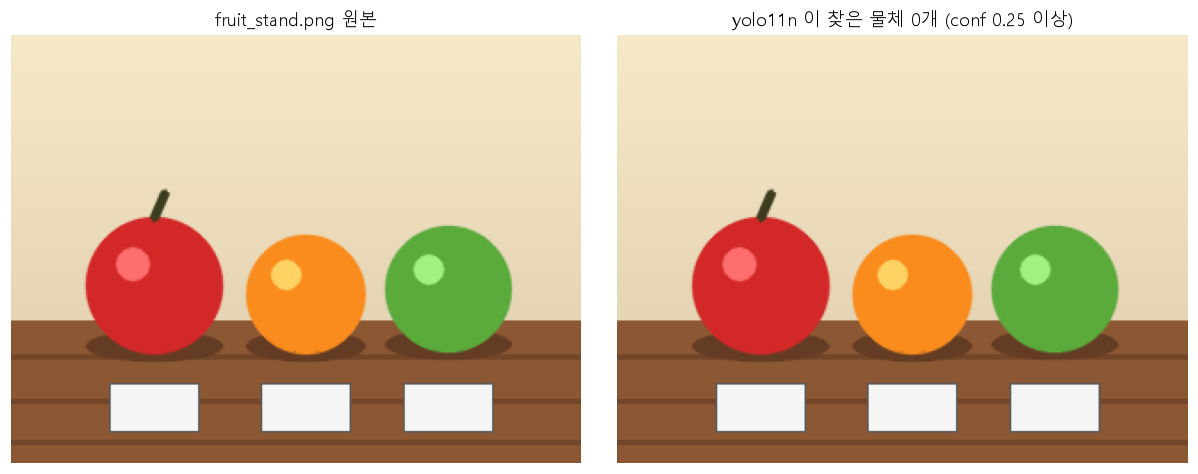
교안 PC 에서 yolo11n 은 이 그림에서 물체를 하나도 찾지 못했습니다(찾은 물체 수 0, 클래스별 개수 {}). 1단계에서 보듯 COCO 에는 apple(47번)과 orange(49번)가 있는데도 못 찾은 까닭은, 이 그림의 과일이 OpenCV 로 그린 동그라미라서 COCO 의 실제 과일 사진과 생김새가 많이 다르기 때문으로 봅니다. 라임은 COCO 의 80가지에 아예 없으므로 처음부터 찾을 수 없습니다. 사전학습 모델은 배운 사진과 비슷한 사진에서만 잘 찾습니다. 우리 부품처럼 COCO 에 없는 물체나 생김새가 다른 그림에 쓰려면 실습 2의 전이 학습이 필요합니다.
코드 설명
os.environ["YOLO_VERBOSE"] = "False"는from ultralytics import YOLO보다 먼저 둬야 듣습니다. 불러온 뒤에 두면 진행 글이 그대로 나옵니다.YOLO("yolo11n.pt")는 가중치 파일을 읽어 모델을 만듭니다.model.names에 이 모델이 아는 80가지 이름이 번호순으로 들어 있습니다.model.predict(img, ...)에는cv2.imread로 읽은 BGR 배열을 그대로 넣습니다. 결과는 그림마다 하나씩 든 목록이라results[0]을 씁니다.cv2.getTextSize로 글자가 차지할 너비와 높이를 재서, 그만큼 검은 띠(thickness=-1, 속 채우기)를 먼저 깔고 흰 글자를 씁니다.- 찾은 물체가 0개면
xyxy는 빈 배열이고zip반복은 한 번도 돌지 않아 오류 없이 넘어갑니다. 이 그림에서는 표도 상자도 비었고, 클래스별 개수는 빈 사전{}입니다.