18장. OpenCV 전처리와 YOLO 연계
실습 3 — 학습한 모델로 부품 찾기
실습 2에서 학습한 out_ch18_runs/parts/weights/best.pt 를 불러와 검증용 사진에서 부품을 찾습니다. 찾은 상자와 17장의 정답 상자를 한 그림에 함께 그려 격자로 보고, 신뢰도 기준값 0.25 와 0.5 에서 찾은 개수를 견줍니다. 실습 2를 먼저 실행해야 합니다.
1단계. 학습한 모델로 한 장 추론하기
import os
from pathlib import Path
os.environ["YOLO_VERBOSE"] = "False"
from ultralytics import YOLO
import cv2
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

weights = Path("out_ch18_runs/parts/weights/best.pt")
if not weights.exists():
    raise SystemExit("best.pt 가 없습니다. 18차시 실습 2를 먼저 실행하세요")
model = YOLO("out_ch18_runs/parts/weights/best.pt")
print("이 모델의 클래스:", model.names)        # 결과: bolt, nut, washer 셋만 남는다

root = Path("out_ch17_yolo")
val_paths = sorted((root / "images" / "val").glob("*.png"))
img = cv2.imread(str(val_paths[0]))
r = model.predict(img, imgsz=320, conf=0.25, device="cpu", verbose=False)[0]
print(val_paths[0].name, "에서 찾은 물체:")
for box, p, c in zip(r.boxes.xyxy.cpu().numpy(), r.boxes.conf.cpu().numpy(), r.boxes.cls.cpu().numpy().astype(int)):
print(f" {r.names[int(c)]:6} 신뢰도 {float(p):.2f} 상자 {[int(v) for v in box]}")이 모델의 클래스: {0: 'bolt', 1: 'nut', 2: 'washer'}
part_001.png 에서 찾은 물체:
washer 신뢰도 0.98 상자 [34, 5, 74, 46]
bolt 신뢰도 0.95 상자 [175, 127, 228, 199]2단계. 정답 상자와 찾은 상자를 함께 그리기
def read_labels(label_path, w, h):
    """YOLO 라벨을 읽어 [(클래스번호, (x1, y1, x2, y2)), ...] 픽셀 상자로 돌려준다(17차시의 되돌리는 식)."""
    boxes = []
    for line in label_path.read_text(encoding="utf-8").split("\n"):
        if not line.strip():
            continue
        c, xc, yc, bw, bh = line.split()
        xc, yc, bw, bh = float(xc), float(yc), float(bw), float(bh)
        boxes.append((int(c), ((xc - bw / 2) * w, (yc - bh / 2) * h, (xc + bw / 2) * w, (yc + bh / 2) * h)))
    return boxes

def detect(model, img, conf=0.25):
    """추론해서 [(클래스번호, 신뢰도, (x1, y1, x2, y2)), ...] 로 돌려준다."""
    r = model.predict(img, imgsz=320, conf=conf, device="cpu", verbose=False)[0]
    return [(int(c), float(p), tuple(float(v) for v in b))
            for b, p, c in zip(r.boxes.xyxy.cpu().numpy(), r.boxes.conf.cpu().numpy(),
                               r.boxes.cls.cpu().numpy().astype(int))]

def draw(img, gts, preds):
    """정답은 초록 얇은 선, 찾은 상자는 빨강 굵은 선과 이름·신뢰도로 그린 사본을 돌려준다."""
    out = img.copy()
    for c, (x1, y1, x2, y2) in gts:
        cv2.rectangle(out, (round(x1), round(y1)), (round(x2), round(y2)), (0, 255, 0), 1)
    for c, p, (x1, y1, x2, y2) in preds:
        cv2.rectangle(out, (int(x1), int(y1)), (int(x2), int(y2)), (0, 0, 255), 2)
        cv2.putText(out, f"{model.names[c]} {p:.2f}", (int(x1), max(int(y1) - 4, 12)),
                    cv2.FONT_HERSHEY_SIMPLEX, 0.4, (0, 0, 255), 1)
    return out

fig, axes = plt.subplots(2, 3, figsize=(11, 5.6), layout="constrained")
for ax, p in zip(axes.ravel(), val_paths[:6]):
    img = cv2.imread(str(p))
    h, w = img.shape[:2]
    gts = read_labels(root / "labels" / "val" / (p.stem + ".txt"), w, h)
    preds = detect(model, img)
    ax.imshow(cv2.cvtColor(draw(img, gts, preds), cv2.COLOR_BGR2RGB))
    ax.set_title(f"{p.name}  정답 {len(gts)} · 찾음 {len(preds)}", fontsize=11)
    ax.axis("off")
fig.suptitle("초록: 정답 상자, 빨강: 학습한 모델이 찾은 상자 (conf 0.25)")
plt.show()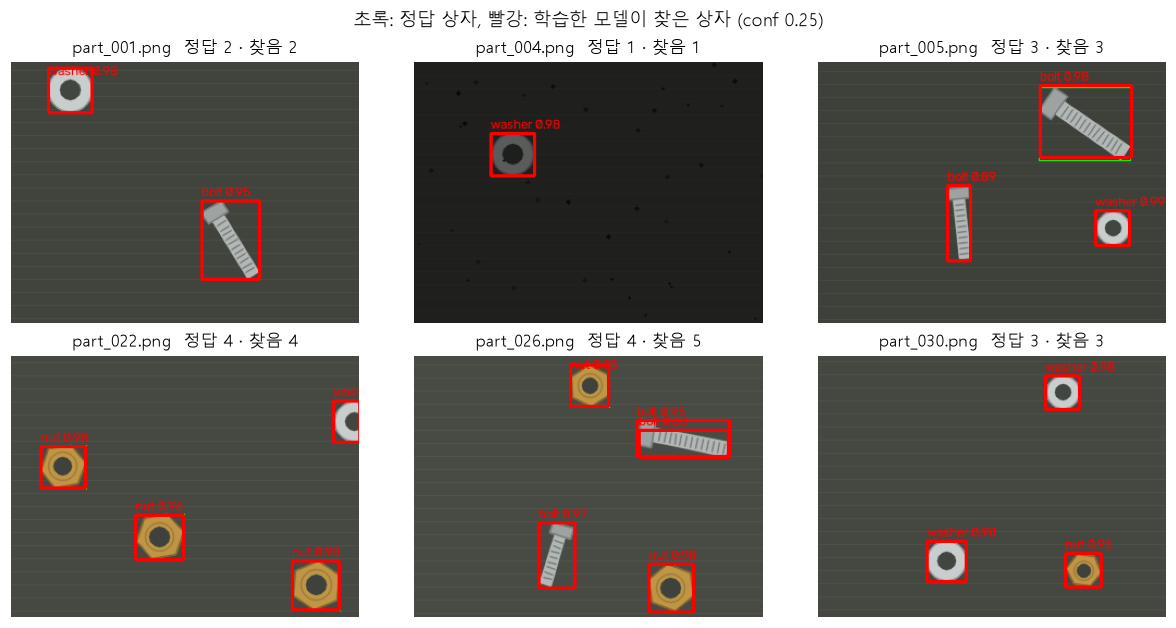
3단계. 신뢰도 기준값 0.25 와 0.5 견주기
import pandas as pd

rows = []
for p in val_paths:
    img = cv2.imread(str(p))
    h, w = img.shape[:2]
    gts = read_labels(root / "labels" / "val" / (p.stem + ".txt"), w, h)
    # 0.25 로 한 번만 추론하고, 0.5 는 그 결과에서 신뢰도로 다시 거른다(결과가 같고 빠르다)
    preds = detect(model, img, conf=0.25)
    rows.append({"그림": p.name, "정답": len(gts),
                 "conf 0.25": len(preds),
                 "conf 0.5": sum(1 for _, s, _ in preds if s >= 0.5)})
table = pd.DataFrame(rows)
print(table.to_string(index=False))
print("합계:", table[["정답", "conf 0.25", "conf 0.5"]].sum().to_dict()) 그림 정답 conf 0.25 conf 0.5
part_001.png 2 2 2
part_004.png 1 1 1
part_005.png 3 3 3
part_022.png 4 4 4
part_026.png 4 5 5
part_030.png 3 3 3
part_031.png 1 1 1
part_034.png 2 2 2
part_037.png 1 1 1
part_049.png 3 3 3
part_053.png 2 2 2
합계: {'정답': 26, 'conf 0.25': 27, 'conf 0.5': 27}교안 PC 에서는 기준값 0.25 와 0.5 모두 27개를 찾아 정답 26개보다 하나 많았습니다. 그림별로 보면 part_026.png 만 정답 4개에 5개를 찾았고, 나머지 10장은 정답 수와 같습니다. 2단계 격자의 part_026.png 를 보면 옆으로 누운 긴 볼트 하나에 빨강 상자 두 개가 겹쳐 있습니다. 0.25 와 0.5 의 개수가 같다는 것은 찾은 상자가 모두 신뢰도 0.5 이상이라는 뜻입니다. 이 가상 그림에서는 모델이 자신 있게 답해서, 기준값을 0.5 로 올려도 놓치는 것이 늘지 않았습니다. 남는 상자가 헛것인지는 실습 4에서 IoU 로 짝지어 확인합니다.
코드 설명
YOLO("out_ch18_runs/parts/weights/best.pt")는 실습 2에서 학습한 가중치를 불러옵니다. 이 모델의names에는 bolt, nut, washer 셋만 있습니다.read_labels는 17장에서 본 되돌리는 식(가운데 ± 크기의 절반, 곱하기 그림 크기)으로 정답을 픽셀 상자로 바꿉니다. 정답과 찾은 상자를 같은 꼴 (x1, y1, x2, y2) 로 맞춰야 견줄 수 있습니다.detect는 추론 결과를 (클래스, 신뢰도, 상자) 묶음의 목록으로 바꿉니다. 실습 4, 5와 프로젝트도 같은 꼴을 씁니다.- 기준값 0.5 의 개수는 0.25 로 추론한 결과에서 신뢰도 0.5 이상만 다시 세어 구했습니다. 신뢰도가 높은 상자는 기준값을 바꿔도 그대로 남으므로, 처음부터 0.5 로 추론한 결과와 같은 개수가 나옵니다.
- 격자의 초록 얇은 선(정답)이 빨강 굵은 선(찾은 상자)에 거의 가려진 것은 두 상자가 잘 겹쳤다는 뜻입니다. 초록 선이 따로 보이면 놓친 것, 짝 없는 빨강 상자는 헛것일 수 있습니다.