2장. 이미지 입출력과 영상 시각화
프로젝트 1 — 상품 사진 저장 형식 비교 보고서
작은 온라인 쇼핑몰의 담당자가 상품 그림을 어떤 형식으로 올릴지 정하려고 합니다. 파일이 작으면 페이지가 빨리 뜨지만, 너무 줄이면 상품 번호 글자가 얼룩져 보입니다. 상품 그림 세 장을 PNG 와 여러 품질의 JPG 로 저장해 보고, 크기와 화질 차이를 표로 비교한 뒤, 확대 비교 그림을 한 장의 보고서 그림으로 남겨 보세요. 쇼핑몰과 상품은 모두 지어낸 것입니다.
| 파일 | 내용 |
|---|---|
ch02_shop/tshirt.png | 줄무늬 티셔츠. 회색 바탕, 넓은 면이 단색 (200×150) |
ch02_shop/sneaker.png | 빨간 운동화. 위에서 아래로 바뀌는 바탕 (200×150) |
ch02_shop/bag.png | 갈색 가방. 촘촘한 천 무늬 바탕 (200×150) |
그림마다 왼쪽 위에 상품 번호(T-01, S-07, B-12)가 영어로 적혀 있습니다.
요구사항
ch02_shop/의 그림 세 장을 읽어 이름, 모양, 원래 PNG 파일 크기를 찍습니다.- 그림마다 PNG 와 JPG 품질 95, 85, 70, 50, 30 으로 저장했을 때의 파일 크기(KB)와 원본과의 평균 절대 차이를 잽니다. 파일을 여러 개 만들지 않도록
cv2.imencode로 메모리 안에서 재 봅니다. - 크기 표와 평균 차이 표를 각각 "그림 × 형식" 꼴로 찍습니다.
- "평균 차이 2.0 이하인 것 가운데 파일이 가장 작은 형식"을 그림마다 골라 추천 표를 찍습니다.
- 그림마다 상품 번호 부분을 PNG, 추천 형식, JPG 30 으로 크게 키워 견준 그림을
out_ch02_report.png로 저장하고 띄웁니다.
힌트
cv2.imencode(".jpg", img, [cv2.IMWRITE_JPEG_QUALITY, q])가 돌려준 바이트의 길이가 파일 크기이고,cv2.imdecode(buf, cv2.IMREAD_COLOR)로 다시 풀어 원본과 견줍니다.- 평균 절대 차이는
np.abs(a.astype(np.int16) - b.astype(np.int16)).mean()입니다. - 결과를 사전 목록으로 모아
pd.DataFrame으로 바꾸고,pivot(index="그림", columns="형식", values="KB")로 표 모양을 바꿉니다. pivot 은 "축을 돌리다"라는 뜻입니다. - 추천은 기준을 넘지 않는 줄만 고른 뒤 KB 가 가장 작은 줄을 그림마다 하나씩 남깁니다.
sort_values("KB")다음groupby("그림").head(1)을 쓰면 됩니다. - 보고서 그림은
plt.subplots(3, 3)격자에interpolation="nearest"로 그리고,plt.show()앞에서fig.savefig를 부릅니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 읽기 | 세 장의 이름, 모양, 파일 크기를 찍는다 | 10 |
| 재기 | 여섯 형식마다 크기와 평균 절대 차이를 바르게 잰다 | 30 |
| 표 | 크기 표와 차이 표를 그림 × 형식 꼴로 찍는다 | 20 |
| 추천 | 기준에 맞는 가장 작은 형식을 그림마다 고른다 | 20 |
| 보고서 그림 | 3×3 확대 비교 그림을 저장하고 띄운다 | 20 |
코드의 흐름
그림의 다섯 단계를 예시 풀이와 같은 순서로 짰습니다. 둘째와 셋째 단계는 파일을 쓰지 않고 imencode 와 imdecode 로 메모리 안에서 저장해 보고 다시 읽습니다. 마지막 단계에서만 savefig 로 파일을 하나 남깁니다.
실제 데이터로 해 보려면
실제 상품 사진으로 같은 비교를 하려면 내가 직접 찍었거나 이용 허락을 받은 사진을 씁니다. 공개 자료가 필요하면 AI Hub(aihub.or.kr)에 상품 이미지 데이터가 공개돼 있습니다. 내려받기 전에 데이터마다 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 사진에 사람의 얼굴이나 개인정보가 찍혀 있으면 처리 기준을 먼저 확인합니다. 실제 사진은 이 연습 그림보다 잔무늬가 많아 PNG 가 훨씬 커지므로, 기준값(평균 차이 2.0)도 사진에 맞게 다시 정합니다.
결과 보기 (예시 풀이)
1단계. 그림 세 장 읽기
import os
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

folder = "ch02_shop"
products = {}
for file in sorted(os.listdir(folder)):
    path = os.path.join(folder, file)
    img = cv2.imread(path)
    if img is None:                                  # 읽지 못한 파일은 건너뛴다
        continue
    name = os.path.splitext(file)[0]
    products[name] = img
    # 요구사항 1: 이름, 모양, 원래 파일 크기
print(f"{name:8} {img.shape} {os.path.getsize(path):,}바이트")bag (150, 200, 3) 19,038바이트
sneaker (150, 200, 3) 4,255바이트
tshirt (150, 200, 3) 4,067바이트2단계. 여섯 형식으로 저장해 보고 재기
# 형식 이름 → (확장자, 옵션 목록)
formats = {"PNG": (".png", [])}
for q in (95, 85, 70, 50, 30):
    formats[f"JPG{q}"] = (".jpg", [cv2.IMWRITE_JPEG_QUALITY, q])

rows = []
for name, img in products.items():
    for fmt, (ext, params) in formats.items():
        # 요구사항 2: 파일을 쓰지 않고 메모리 안에서 인코딩한다
        ok, buf = cv2.imencode(ext, img, params)
        back = cv2.imdecode(buf, cv2.IMREAD_COLOR)   # 다시 풀어 원본과 견준다
        mae = np.abs(img.astype(np.int16) - back.astype(np.int16)).mean()
        rows.append({"그림": name, "형식": fmt,
                     "KB": round(len(buf) / 1024, 1),
                     "평균차이": round(float(mae), 3)})
result = pd.DataFrame(rows)
print("잰 횟수:", len(result))잰 횟수: 183단계. 크기 표와 차이 표
order = list(formats)                                # 표의 칸 차례: PNG, JPG95, …, JPG30
# 요구사항 3: pivot 으로 "그림 × 형식" 꼴로 바꾼다
size_table = result.pivot(index="그림", columns="형식", values="KB")[order]
diff_table = result.pivot(index="그림", columns="형식", values="평균차이")[order]
print("[파일 크기 KB]")
print(size_table.to_string())
print()
print("[원본과의 평균 절대 차이]")
print(diff_table.to_string())[파일 크기 KB]
형식 PNG JPG95 JPG85 JPG70 JPG50 JPG30
그림
bag 18.6 10.6 6.0 3.8 3.0 2.5
sneaker 4.2 5.6 3.6 2.7 2.3 2.0
tshirt 4.0 5.8 4.1 3.3 2.8 2.4
[원본과의 평균 절대 차이]
형식 PNG JPG95 JPG85 JPG70 JPG50 JPG30
그림
bag 0.0 1.342 2.315 3.106 3.773 4.480
sneaker 0.0 1.125 1.553 2.075 2.693 3.590
tshirt 0.0 1.277 1.775 2.280 2.674 3.6934단계. 기준으로 추천 형식 고르기
limit = 2.0                                          # 평균 차이의 기준값
ok_rows = result[result["평균차이"] <= limit]          # 기준을 넘지 않는 줄만 남긴다
# 요구사항 4: KB 가 작은 차례로 줄 세운 뒤 그림마다 첫 줄 하나씩
pick = ok_rows.sort_values("KB").groupby("그림").head(1).set_index("그림").loc[list(products)]
pick["PNG대비"] = [round(float(pick.loc[n, "KB"] / size_table.loc[n, "PNG"]), 2) for n in pick.index]
print(f"[추천: 평균 차이 {limit} 이하에서 가장 작은 형식]")
print(pick.to_string())[추천: 평균 차이 2.0 이하에서 가장 작은 형식]
형식 KB 평균차이 PNG대비
그림
bag JPG95 10.6 1.342 0.57
sneaker JPG85 3.6 1.553 0.86
tshirt PNG 4.0 0.000 1.005단계. 확대 비교 보고서 그림
fig, axes = plt.subplots(3, 3, figsize=(9, 5.4), layout="constrained")
for r, name in enumerate(products):
    img = products[name]
    best = pick.loc[name, "형식"]
    for c, fmt in enumerate(["PNG", best, "JPG30"]):
        ext, params = formats[fmt]
        back = cv2.imdecode(cv2.imencode(ext, img, params)[1], cv2.IMREAD_COLOR)
        piece = back[4:28, 4:64]                     # 왼쪽 위 상품 번호 부분(세로 24, 가로 60칸)
        ax = axes[r, c]
        ax.imshow(cv2.cvtColor(piece, cv2.COLOR_BGR2RGB), interpolation="nearest")
        kb = result[(result["그림"] == name) & (result["형식"] == fmt)]["KB"].iloc[0]
        ax.set_title(f"{name} · {fmt} · {kb}KB", fontsize=10)
        ax.axis("off")
fig.suptitle("상품 번호 부분 확대: 원본(PNG) · 추천 형식 · JPG 30")
# 요구사항 5: 띄우기 전에 저장한다
fig.savefig("out_ch02_report.png", dpi=120, bbox_inches="tight")
print("저장: out_ch02_report.png")
plt.show()저장: out_ch02_report.png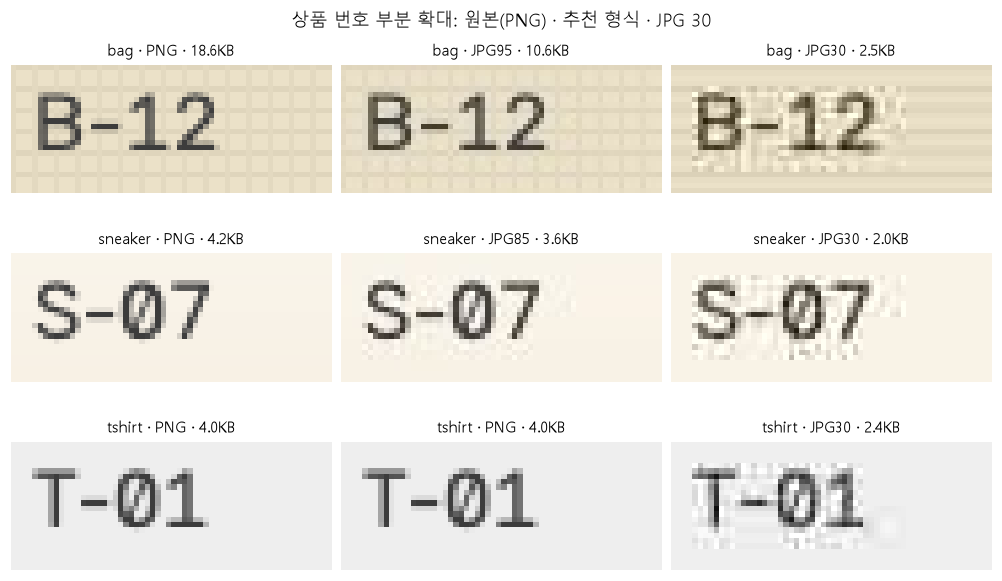
결과를 읽어 봅니다. 세 상품의 추천이 모두 달랐습니다. 가방은 천 무늬 때문에 PNG 가 18.6KB 로 가장 컸고, JPG 85 는 평균 차이가 2.315 로 기준 2.0 을 넘어, 기준을 지키는 가장 작은 형식은 JPG 95(10.6KB, PNG 의 0.57배)였습니다. 운동화는 JPG 85(3.6KB, 평균 차이 1.553)가 PNG(4.2KB)의 0.86배로 추천됐고, 한 단계 낮은 JPG 70 은 평균 차이 2.075 로 기준을 조금 넘었습니다. 티셔츠는 넓은 면이 단색이라 PNG 가 4.0KB 로 JPG 95(5.8KB)와 JPG 85(4.1KB)보다 작아, 숫자도 그대로인 PNG 가 추천됐습니다. 보고서 그림의 오른쪽 칸(JPG 30)에서는 세 상품 모두 번호 글자 둘레에 얼룩이 보이지만, 가운데 칸(추천 형식)은 왼쪽의 PNG 와 눈으로 구별하기 어렵습니다. 모든 상품에 품질 하나만 정해야 한다면 세 장 모두 기준을 지키는 것은 JPG 95 뿐인데, 이때 티셔츠와 운동화는 오히려 PNG 보다 파일이 커집니다. 그래서 이 쇼핑몰의 그림처럼 단순한 상품 그림은 그림마다 PNG 와 JPG 를 견줘 고르는 편이 낫다는 결론을 낼 수 있습니다. 이 결론은 연습용 가상 그림 세 장에서 나온 것이고, 실제 사진에서는 숫자가 달라집니다.