19장. Vision 데이터 파이프라인
실습 5 — 동영상에도 같은 파이프라인
같은 파이프라인을 동영상 ch19_belt.mp4 에 겁니다. 수집 단계만 "4장마다 한 장 뽑기"로 바꾸고, 거르기·다듬기·추론은 그림 폴더와 같은 함수를 씁니다. 프레임마다 찾은 물체 수를 정답(ch19_belt_answer.csv, 반 넘게 보이는 부품)과 견주어 그래프로 그립니다. 18장 실습 2를 먼저 실행해야 합니다.
1단계. 동영상 수집 단계
import os
from pathlib import Path
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

CONFIG = {"every": 4, "dark_drop": 30, "blur_min": 30, "size": [320, 240], "dark_fix": 50,
          "gamma": 0.7, "noise_max": 3.0, "denoise_ksize": 5, "conf": 0.25}

def collect_video(path, config):
    """수집 단계(동영상): every 장마다 한 장을 뽑아 항목 목록으로 돌려준다."""
    cap = cv2.VideoCapture(path)
    if not cap.isOpened():                              # 없는 파일도 오류 없이 False(15차시)
        raise SystemExit(f"{path} 를 열 수 없습니다")
    items, no = [], 0
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        if no % config["every"] == 0:
            items.append({"file": f"frame_{no:03d}", "source": f"{path}#{no}", "frame": no, "img": frame})
        no += 1
    cap.release()
    return items, no

frames, total = collect_video("ch19_belt.mp4", CONFIG)
print("전체", total, "장 가운데", len(frames), "장을 모음:", [f["frame"] for f in frames])전체 48 장 가운데 12 장을 모음: [0, 4, 8, 12, 16, 20, 24, 28, 32, 36, 40, 44]2단계. 같은 거르기·다듬기 함수 걸기
def check_frame(img, config):
    """거르기(동영상): 파일이 없으므로 밝기와 흐림 관문만 본다."""
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    mean, blur = float(gray.mean()), float(cv2.Laplacian(gray, cv2.CV_64F).var())
    if mean < config["dark_drop"]:
        return "탈락", f"아주 어두움({mean:.1f})"
    if blur < config["blur_min"]:
        return "탈락", f"흐림({blur:.1f})"
    return "통과", f"밝기 {mean:.1f}, 흐림 {blur:.1f}"

def noise_score(img):
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    return float(cv2.absdiff(gray, cv2.medianBlur(gray, 3)).mean())

def prep_one(img, config):
    """실습 2와 같은 다듬기: 크기, 밝기, 잡음."""
    notes, (w, h) = [], config["size"]
    scale = w / img.shape[1]
    if img.shape[:2] != (h, w):
        img = cv2.resize(img, (w, h), interpolation=cv2.INTER_AREA)
        notes.append(f"크기 {scale:g}배")
    if float(cv2.cvtColor(img, cv2.COLOR_BGR2GRAY).mean()) < config["dark_fix"]:
        lut = np.array([((i / 255) ** config["gamma"]) * 255 for i in range(256)]).round().astype(np.uint8)
        img = cv2.LUT(img, lut)
        notes.append("감마")
    if noise_score(img) > config["noise_max"]:
        k = config["denoise_ksize"]
        img = cv2.GaussianBlur(img, (k, k), 0)
        notes.append("블러")
    return img, scale, notes

kept = []
for f in frames:
    result, reason = check_frame(f["img"], CONFIG)
    if result == "통과":
        img, scale, notes = prep_one(f["img"], CONFIG)
        kept.append({**f, "img": img, "scale": scale, "notes": ", ".join(notes)})
    else:
        print(f["file"], result, reason)
print("거르기·다듬기 뒤 남은 프레임:", len(kept), "/ 손질한 프레임:", [k["file"] for k in kept if k["notes"]])거르기·다듬기 뒤 남은 프레임: 12 / 손질한 프레임: []3단계. 프레임마다 추론하고 개수 세기
os.environ["YOLO_VERBOSE"] = "False"
from ultralytics import YOLO

if not Path("out_ch18_runs/parts/weights/best.pt").exists():
    raise SystemExit("best.pt 가 없습니다. 18차시 실습 2를 먼저 실행하세요")
model = YOLO("out_ch18_runs/parts/weights/best.pt")

answer = pd.read_csv("ch19_belt_answer.csv")
rows = []
for k in kept:
    r = model.predict(k["img"], imgsz=CONFIG["size"][0], conf=CONFIG["conf"], device="cpu", verbose=False)[0]
    names = [r.names[int(c)] for c in r.boxes.cls.cpu().numpy().astype(int)]
    rows.append({"frame": k["frame"], "찾음": len(names),
                 "정답": int((answer["frame"] == k["frame"]).sum()),   # 반 넘게 보이는 부품 수
                 "클래스": ", ".join(sorted(names))})
counts = pd.DataFrame(rows)
counts.to_csv("out_ch19_video_counts.csv", index=False, encoding="utf-8-sig")
print(counts.to_string(index=False))
print("개수가 맞은 프레임:", int((counts["찾음"] == counts["정답"]).sum()), "/", len(counts)) frame 찾음 정답 클래스
0 1 1 nut
4 2 1 bolt, nut
8 2 2 bolt, nut
12 2 2 bolt, nut
16 2 2 bolt, nut
20 3 3 bolt, nut, washer
24 3 3 bolt, nut, washer
28 4 3 bolt, nut, nut, washer
32 4 4 bolt, nut, nut, washer
36 4 3 bolt, nut, nut, washer
40 4 3 bolt, nut, washer, washer
44 4 4 bolt, nut, washer, washer
개수가 맞은 프레임: 8 / 124단계. 프레임별 물체 수 그래프
fig, ax = plt.subplots(figsize=(9, 3.8), layout="constrained")
ax.plot(counts["frame"], counts["정답"], marker="o", label="정답(반 넘게 보이는 부품)")
ax.plot(counts["frame"], counts["찾음"], marker="s", linestyle="--", label="찾은 물체")
ax.set_xlabel("프레임 번호")
ax.set_ylabel("물체 수")
ax.set_yticks(range(0, int(max(counts["정답"].max(), counts["찾음"].max())) + 2))
ax.legend(loc="upper left")
ax.set_title("프레임별 물체 수 (ch19_belt.mp4, 4장마다 한 장)")
plt.show()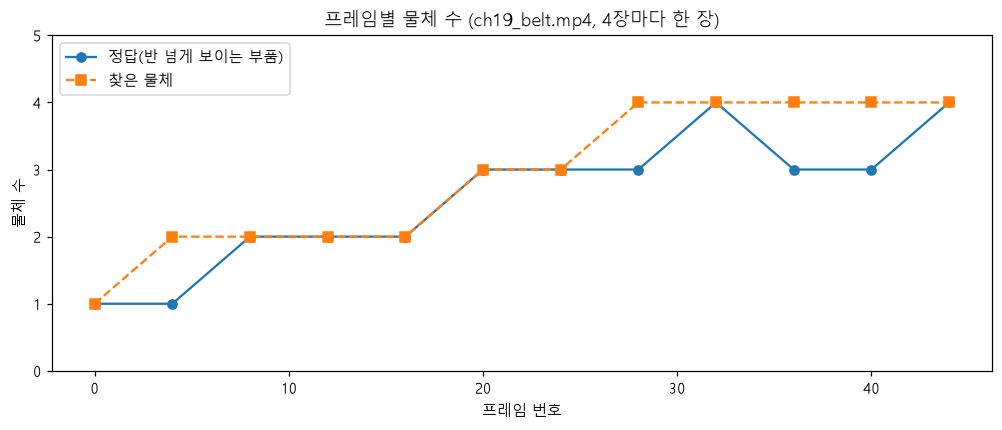
코드 설명
collect_video는 그림 폴더의collect와 같은 꼴(항목 사전의 목록)을 돌려주므로, 뒤의 거르기·다듬기·추론은 그대로 쓸 수 있습니다. 바뀌는 단계는 수집 하나뿐입니다.- 동영상 프레임은 파일이 아니라서 빈 파일·깨짐·MD5 중복 관문을 빼고 밝기와 흐림만 봅니다. 이웃한 프레임은 원래 서로 비슷하므로 평균 해시 중복 검사도 걸지 않습니다.
- 정답은 부품이 반 넘게 보이는 프레임에서만 셉니다. 그림 가장자리에 조금만 걸친 부품은 정답에 없으므로, 모델이 그것을 찾으면 "찾음"이 정답보다 클 수 있습니다.
- 12프레임 가운데 8프레임에서 개수가 맞았습니다. 틀린 4프레임(4, 28, 36, 40번)은 모두 "찾음"이 정답보다 하나 많았고, 많은 쪽은 그림 왼쪽으로 들어오거나 오른쪽으로 나가는, 반이 안 보이는 부품이었습니다(예: 4번 프레임의 bolt, 36번 프레임의 nut). 모델이 틀렸다기보다 "반 넘게 보여야 센다"는 정답의 규칙과 어긋난 것입니다. 개수를 셀 때는 그림 가장자리에 걸친 상자를 빼거나, 정답과 같은 규칙을 정해 두어야 합니다.