19장. Vision 데이터 파이프라인
프로젝트 1 — 부품 입고 검사 파이프라인 완성
부품 탐지 수업을 준비하는 강사라고 해 봅시다. 수강생이 매주 새로 찍은 부품 사진 폴더를 보내오면, 쓸 수 없는 사진을 빼고, 모델로 부품을 세고, 결과를 한 장의 보고서로 돌려주려고 합니다. 매주 같은 일을 손으로 하지 않도록, 폴더 이름과 설정만 주면 수집부터 보고까지 한 번에 도는 함수 run_pipeline(folder, config) 를 만듭니다. 정답표가 함께 있으면 정밀도와 재현율까지 잽니다.
| 파일 | 내용 |
|---|---|
ch19_incoming/belt_*.png, belt_*.jpg | 새로 들어온 가상 부품 그림 24장(문제 파일 섞임) |
ch19_incoming/answer.csv | 정답 상자(filename, class, x1, y1, x2, y2). 원래 그림 크기의 픽셀 좌표 |
ch19_incoming/issues.csv | 일부러 섞은 문제(filename, issue). 결과를 확인할 때만 본다 |
out_ch18_runs/parts/weights/best.pt | 18장 실습 2에서 학습한 모델 |
요구사항
- 기준값을 모두 CONFIG 사전 하나에 두고,
run_pipeline(folder, config)가 config 만 보고 돌게 합니다. CONFIG 는out_ch19_config.json으로 저장합니다. - 수집, 거르기(네 관문), 다듬기, 추론 단계를 함수로 나누고, 단계마다 걸린 시간(초)을 찍습니다.
- 단계별 남은 그림 수(깔때기 표)와 클래스별 찾은 개수를 찍습니다.
- 정답표와 견주어 IoU 0.5 이상, 같은 클래스면 맞힘으로 보고 정밀도와 재현율을 찍습니다. 채점은 거르기를 통과한 그림의 정답만 셉니다.
- 그림마다 마지막 단계, 결과, 이유, 손질, 찾은 수, 정답 수, 맞힌 수를 적은
out_ch19_report.csv를 저장합니다. - 상자 그림 넷, 클래스별 개수, 깔때기를 한 장에 모은 요약 그림
out_ch19_report.png를 저장하고 띄웁니다. - 결론을 실제 숫자로 적습니다.
힌트
- 실습 1·2·3의 함수를 그대로 가져오되, 함수 안에 숫자가 남지 않았는지 확인합니다.
30,0.7같은 숫자가 보이면 config 의 열쇠로 바꿉니다. - 단계 시간은
start = time.perf_counter()를 단계 앞에 두고, 끝난 뒤time.perf_counter() - start를 사전에 모읍니다. - IoU 는 18장처럼 겹친 사각형의 가로 × 세로 ÷ (두 넓이의 합 − 겹친 넓이)입니다. 겹치지 않으면 가로나 세로가 0 이하가 되므로
max(0, ...)로 막습니다. - 맞힘 짝짓기는 신뢰도가 높은 예측부터, 아직 짝이 없는 같은 클래스 정답 가운데 IoU 가 가장 큰 것과 짝짓습니다. 정답 하나는 예측 하나와만 짝짓습니다.
- 정밀도 = 맞힌 수 ÷ 찾은 수, 재현율 = 맞힌 수 ÷ 정답 수입니다. 0 으로 나누지 않게 찾은 수가 0 이면 0 으로 둡니다.
- 요약 그림은
plt.figure에add_gridspec(2, 4)로 칸을 나눠 위 줄에 상자 그림 넷, 아래 줄에 막대 두 개를 놓습니다.
채점 기준
| 항목 | 기준 | 점수 |
|---|---|---|
| 설정 | 기준값이 모두 CONFIG 에 있고 json 으로 저장한다 | 10 |
| 단계 함수 | 네 단계를 함수로 나누고 단계별 시간을 찍는다 | 20 |
| 깔때기와 개수 | 단계별 남은 수와 클래스별 개수를 찍는다 | 15 |
| 채점 | IoU 0.5 짝짓기로 정밀도·재현율을 바르게 잰다 | 20 |
| 보고표 | 그림마다 결과와 개수를 적은 csv 를 저장한다 | 15 |
| 요약 그림 | 상자 그림, 클래스 막대, 깔때기를 한 장에 저장한다 | 10 |
| 결론 | 실제 숫자로 적는다 | 10 |
코드의 흐름
그림의 다섯 단계를 run_pipeline 이 차례로 부릅니다. 앞의 네 단계는 실습 1부터 실습 3까지의 함수를 CONFIG 하나로 묶은 것이고, 다섯째 단계에서 정답표와 견주어 채점하고 보고표와 요약 그림을 남깁니다. 예시 풀이도 이 순서로 함수를 하나씩 만든 뒤 마지막에 한 번 부릅니다.
실제 데이터로 해 보려면
실제 사진으로 해 보려면 AI Hub(aihub.or.kr)에서 제조 부품이나 물류 물품처럼 상자 주석이 함께 있는 이미지 자료를 찾아 내려받습니다. 내려받기 전에 이용 약관(상업적 이용 가능 여부, 재배포 금지 등)을 확인하고, 사람이 찍힌 사진은 얼굴과 개인정보가 드러나지 않게 다룹니다. 실제 사진은 크기와 밝기가 훨씬 다양하므로, CONFIG 의 dark_drop, blur_min, hash_max 를 실습 1처럼 분포와 가장 가까운 거리를 먼저 본 뒤 정합니다. 가로세로 비율이 제각각이면 다듬기의 크기 맞추기를 16장의 레터박스로 바꾸고, 상자를 되돌릴 때 덧댄 여백만큼 빼는 계산을 더합니다. 모델도 그 데이터로 18장처럼 다시 학습해야 합니다.
결과 보기 (예시 풀이)
1단계. 설정과 수집·거르기 함수
import hashlib
import json
import os
import time
from pathlib import Path
import cv2
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

plt.rcParams["font.family"] = "Malgun Gothic"
plt.rcParams["axes.unicode_minus"] = False

CONFIG = {
    "exts": [".png", ".jpg", ".jpeg"], "min_side": 64,
    "dark_drop": 30, "blur_min": 30, "hash_max": 2,
    "size": [320, 240], "dark_fix": 50, "gamma": 0.7, "noise_max": 3.0, "denoise_ksize": 5,
    "weights": "out_ch18_runs/parts/weights/best.pt", "conf": 0.25,
    "iou_hit": 0.5, "seed": 19,
}

def collect(folder, config):
    """수집: 확장자로 그림만 고른다."""
    return [{"file": p.name, "source": p.as_posix(), "bytes": p.stat().st_size}
            for p in sorted(Path(folder).iterdir()) if p.is_file() and p.suffix.lower() in config["exts"]]

def gray_of(img):
    return cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)

def ahash(img):
    small = cv2.resize(gray_of(img), (8, 8), interpolation=cv2.INTER_AREA)
    return (small > small.mean()).flatten()

def filter_stage(items, config):
    """거르기: 읽기 → 밝기 → 흐림 → 중복. 탈락하면 이유를 기록한다."""
    passed, log, seen = [], [], []
    for it in items:
        reason, img = "", None
        if it["bytes"] == 0:
            reason = "빈 파일"
        else:
            img = cv2.imread(it["source"])
            if img is None:
                reason = "깨짐"
            elif min(img.shape[:2]) < config["min_side"]:
                reason = "너무 작음"
        if not reason:
            mean = float(gray_of(img).mean())
            blur = float(cv2.Laplacian(gray_of(img), cv2.CV_64F).var())
            if mean < config["dark_drop"]:
                reason = f"아주 어두움({mean:.1f})"
            elif blur < config["blur_min"]:
                reason = f"흐림({blur:.1f})"
        if not reason:
            with open(it["source"], "rb") as f:
                digest = hashlib.md5(f.read()).hexdigest()
            bits = ahash(img)
            for other, d, b in seen:
                if d == digest or int((b != bits).sum()) <= config["hash_max"]:
                    reason = f"중복({other})"
                    break
        if reason:
            log.append({"file": it["file"], "stage": "거르기", "result": "탈락", "reason": reason})
        else:
            seen.append((it["file"], digest, bits))
            passed.append({**it, "img": img})
    return passed, log

# 수집과 거르기만 먼저 시험한다
test_passed, test_log = filter_stage(collect("ch19_incoming", CONFIG), CONFIG)
print("통과", len(test_passed), "장 · 탈락", [(r["file"], r["reason"]) for r in test_log])통과 18 장 · 탈락 [('belt_011.png', '아주 어두움(21.7)'), ('belt_013.png', '흐림(0.9)'), ('belt_021.png', '중복(belt_003.png)'), ('belt_022.jpg', '중복(belt_010.png)'), ('belt_023.png', '깨짐'), ('belt_024.png', '빈 파일')]2단계. 다듬기·추론 함수
def prep_stage(items, config):
    """다듬기: 크기 → 밝기 → 잡음. 비율과 손질을 항목에 적는다."""
    w, h = config["size"]
    lut = np.array([((i / 255) ** config["gamma"]) * 255 for i in range(256)]).round().astype(np.uint8)
    out = []
    for it in items:
        img, notes = it["img"], []
        scale = w / img.shape[1]
        if img.shape[:2] != (h, w):
            img = cv2.resize(img, (w, h), interpolation=cv2.INTER_AREA)
            notes.append(f"크기 {scale:g}배")
        if float(gray_of(img).mean()) < config["dark_fix"]:
            img = cv2.LUT(img, lut)
            notes.append(f"감마 {config['gamma']}")
        g = gray_of(img)
        if float(cv2.absdiff(g, cv2.medianBlur(g, 3)).mean()) > config["noise_max"]:
            k = config["denoise_ksize"]
            img = cv2.GaussianBlur(img, (k, k), 0)
            notes.append(f"블러 {k}x{k}")
        out.append({**it, "img": img, "scale": scale, "notes": ", ".join(notes)})
    return out

def infer_stage(items, model, config):
    """추론: 그림마다 predict 하고 상자를 원래 좌표로 되돌린 물체 표를 돌려준다."""
    found = []
    for it in items:
        r = model.predict(it["img"], imgsz=config["size"][0], conf=config["conf"], device="cpu", verbose=False)[0]
        for (x1, y1, x2, y2), c, k in zip(r.boxes.xyxy.cpu().numpy(), r.boxes.conf.cpu().numpy(),
                                          r.boxes.cls.cpu().numpy().astype(int)):
            s = it["scale"]
            found.append({"file": it["file"], "class": r.names[int(k)], "conf": round(float(c), 3),
                          "x1": float(x1) / s, "y1": float(y1) / s, "x2": float(x2) / s, "y2": float(y2) / s})
    return pd.DataFrame(found, columns=["file", "class", "conf", "x1", "y1", "x2", "y2"])

# 다듬기만 시험한다(추론은 4단계에서 모델을 불러 함께 돈다)
test_prepped = prep_stage(test_passed, CONFIG)
print("손질:", {it["file"]: it["notes"] for it in test_prepped if it["notes"]})손질: {'belt_004.png': '감마 0.7', 'belt_008.jpg': '블러 5x5', 'belt_016.png': '크기 0.5배'}3단계. IoU 와 채점 함수
def iou(a, b):
    """두 상자 (x1, y1, x2, y2) 의 겹친 넓이 ÷ 합친 넓이(18차시)."""
    w = max(0.0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0.0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter
    return inter / union if union > 0 else 0.0

# 손계산: (0,0,10,10) 과 (5,0,15,10) 은 겹친 넓이 50, 합친 넓이 100 + 100 - 50 = 150
print("IoU 손계산:", round(iou((0, 0, 10, 10), (5, 0, 15, 10)), 3))

def match_count(preds, truths, thr):
    """같은 그림의 예측과 정답을 짝지어 맞힌 수를 센다. 신뢰도 높은 예측부터, 정답 하나에 예측 하나."""
    used, hits = set(), 0
    for p in sorted(preds, key=lambda d: -d["conf"]):
        best, best_j = 0.0, None
        for j, t in enumerate(truths):
            if j in used or t["class"] != p["class"]:
                continue
            v = iou((p["x1"], p["y1"], p["x2"], p["y2"]), (t["x1"], t["y1"], t["x2"], t["y2"]))
            if v > best:
                best, best_j = v, j
        if best_j is not None and best >= thr:
            used.add(best_j)
            hits += 1
    return hits

# 작은 시험: 예측 둘(하나는 클래스가 틀림), 정답 하나
p = [{"class": "nut", "conf": 0.9, "x1": 0, "y1": 0, "x2": 10, "y2": 10},
     {"class": "bolt", "conf": 0.8, "x1": 0, "y1": 0, "x2": 10, "y2": 10}]
t = [{"class": "nut", "x1": 1, "y1": 0, "x2": 11, "y2": 10}]
print("맞힌 수:", match_count(p, t, 0.5))IoU 손계산: 0.333
맞힌 수: 14단계. run_pipeline 으로 묶기
def run_pipeline(folder, config):
    """수집 → 거르기 → 다듬기 → 추론 → 채점·보고. 결과 표들을 사전으로 돌려준다."""
    times = {}
    Path("out_ch19_config.json").write_text(json.dumps(config, ensure_ascii=False, indent=2), encoding="utf-8")

    start = time.perf_counter()
    items = collect(folder, config)
    times["수집"] = time.perf_counter() - start

    start = time.perf_counter()
    passed, log = filter_stage(items, config)
    times["거르기"] = time.perf_counter() - start

    start = time.perf_counter()
    prepped = prep_stage(passed, config)
    times["다듬기"] = time.perf_counter() - start

    start = time.perf_counter()
    os.environ["YOLO_VERBOSE"] = "False"
    from ultralytics import YOLO
    if not Path(config["weights"]).exists():
        raise SystemExit("best.pt 가 없습니다. 18차시 실습 2를 먼저 실행하세요")
    model = YOLO("out_ch18_runs/parts/weights/best.pt")
    det = infer_stage(prepped, model, config)
    times["추론"] = time.perf_counter() - start

    # 채점: 통과한 그림의 정답만 센다
    answer_path = Path(folder) / "answer.csv"
    answer = pd.read_csv(answer_path) if answer_path.exists() else pd.DataFrame(columns=["filename"])
    rows = list(log)
    for it in prepped:
        preds = det[det["file"] == it["file"]].to_dict("records")
        truths = answer[answer["filename"] == it["file"]].to_dict("records")
        rows.append({"file": it["file"], "stage": "추론", "result": "통과", "reason": "", "notes": it["notes"],
                     "found": len(preds), "truth": len(truths),
                     "hits": match_count(preds, truths, config["iou_hit"])})
    report = pd.DataFrame(rows).sort_values("file").reset_index(drop=True)
    # 탈락한 그림은 개수 칸이 비어 소수(1.0)로 바뀌므로, 빈 칸을 허용하는 정수형(Int64)으로 되돌린다
    report[["found", "truth", "hits"]] = report[["found", "truth", "hits"]].astype("Int64")
    report.to_csv("out_ch19_report.csv", index=False, encoding="utf-8-sig")
    return {"items": items, "prepped": prepped, "log": log, "det": det, "report": report, "times": times}

out = run_pipeline("ch19_incoming", CONFIG)
print("단계별 시간(초):", {k: round(v, 3) for k, v in out["times"].items()})
print("저장: out_ch19_config.json, out_ch19_report.csv")단계별 시간(초): {'수집': 0.003, '거르기': 0.069, '다듬기': 0.009, '추론': 7.375}
저장: out_ch19_config.json, out_ch19_report.csv5단계. 깔때기, 채점, 요약 그림
report, det = out["report"], out["det"]
# 깔때기: 탈락 이유의 첫 낱말로 단계를 나눈다
gates = [("읽기", ("빈 파일", "깨짐", "너무 작음")), ("밝기", ("아주 어두움",)), ("흐림", ("흐림",)), ("중복", ("중복",))]
reasons = report["reason"].fillna("")
funnel, left = [("수집", len(out["items"]))], len(out["items"])
for name, heads in gates:
    left -= int(reasons.str.startswith(heads).sum())
    funnel.append((name, left))
funnel.append(("다듬기", len(out["prepped"])))
print("깔때기:", funnel)

counts = det["class"].value_counts().reindex(["bolt", "nut", "washer"], fill_value=0)
print("클래스별 찾은 개수:", counts.to_dict())

found, truth, hits = int(report["found"].sum()), int(report["truth"].sum()), int(report["hits"].sum())
precision = hits / found if found else 0.0
recall = hits / truth if truth else 0.0
print(f"찾음 {found} · 정답 {truth} · 맞힘 {hits} → 정밀도 {precision:.3f}, 재현율 {recall:.3f}")
missed = report[(report["stage"] == "추론") & (report["hits"] < report["truth"])]["file"].tolist()
print("놓친 물체가 있는 그림:", missed)

# 요약 그림: 위 줄에 상자 그림 넷(씨앗으로 고름), 아래 줄에 클래스 막대와 깔때기
COLORS = {"bolt": (76, 139, 95), "nut": (38, 93, 254), "washer": (190, 125, 142)}
rng = np.random.default_rng(CONFIG["seed"])
picks = sorted(rng.choice([it["file"] for it in out["prepped"]], 4, replace=False).tolist())
fig = plt.figure(figsize=(14, 7.5), layout="constrained")
gs = fig.add_gridspec(2, 4)
for k, name in enumerate(picks):
    it = next(p for p in out["prepped"] if p["file"] == name)
    canvas = it["img"].copy()
    for b in det[det["file"] == name].itertuples():
        p1 = (round(b.x1 * it["scale"]), round(b.y1 * it["scale"]))
        p2 = (round(b.x2 * it["scale"]), round(b.y2 * it["scale"]))
        cv2.rectangle(canvas, p1, p2, COLORS[b[2]], 2)
        cv2.putText(canvas, b[2], (p1[0], max(p1[1] - 4, 10)), cv2.FONT_HERSHEY_SIMPLEX, 0.4, COLORS[b[2]], 1, cv2.LINE_AA)
    ax = fig.add_subplot(gs[0, k])
    ax.imshow(cv2.cvtColor(canvas, cv2.COLOR_BGR2RGB))
    ax.set_title(name)
    ax.axis("off")
ax = fig.add_subplot(gs[1, :2])
ax.bar(counts.index, counts.values)
ax.set_title(f"클래스별 찾은 개수 (정밀도 {precision:.3f}, 재현율 {recall:.3f})")
ax = fig.add_subplot(gs[1, 2:])
ax.bar([n for n, _ in funnel], [v for _, v in funnel])
for x, (_, v) in enumerate(funnel):
    ax.text(x, v + 0.3, str(v), ha="center")
ax.set_ylim(0, funnel[0][1] * 1.2)
ax.set_title("단계별 남은 그림 수")
fig.savefig("out_ch19_report.png", dpi=80)
plt.show()
print("저장: out_ch19_report.png")깔때기: [('수집', 24), ('읽기', 22), ('밝기', 21), ('흐림', 20), ('중복', 18), ('다듬기', 18)]
클래스별 찾은 개수: {'bolt': 16, 'nut': 16, 'washer': 25}
찾음 57 · 정답 53 · 맞힘 53 → 정밀도 0.930, 재현율 1.000
놓친 물체가 있는 그림: []
저장: out_ch19_report.png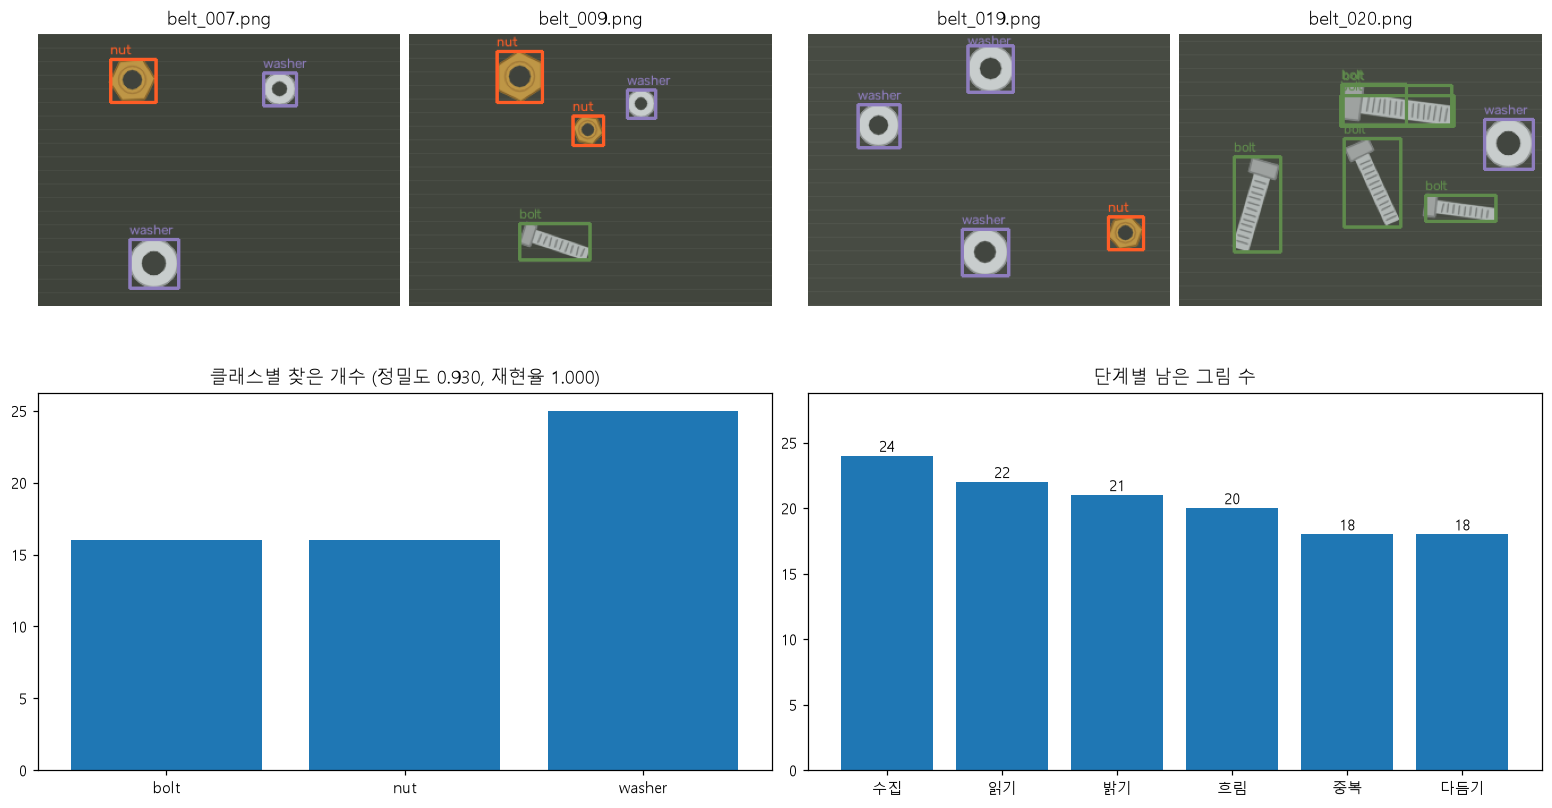
통과한 18장에서 57개를 찾았고, 정답 53개를 모두 맞혀 정밀도 0.930(53 ÷ 57), 재현율 1.000 이 나왔습니다. 놓친 물체는 하나도 없고, 틀린 상자 4개는 실습 3에서 본 대로 belt_018.png 와 belt_020.png 의 bolt 위에 겹친 부분 상자입니다. 이 네 상자의 신뢰도는 0.29~0.53 이고 맞힌 상자는 모두 0.82 이상이어서, 이 묶음에서는 CONFIG 의 conf 를 0.6 쯤으로 올리면 틀린 상자만 빠질 것으로 보입니다(다시 돌려 확인하지는 않았습니다). 18장에서 이 모델은 어두운 그림에는 강하고 잡음에는 약했습니다. 이 장에서는 어두운 belt_004.png 를 감마로 밝히고 노이즈 낀 belt_008.jpg 에 블러를 건 뒤 넣어 둘 다 맞혔습니다. 블러 없이 넣었을 때의 결과는 돌려 보지 않았으므로, 다듬기의 효과를 재려면 18장처럼 손질 전후를 함께 추론해 견줘야 합니다. 단계별 시간은 추론이 거르기보다 수십 배, 다듬기보다 수백 배 오래 걸려 이 파이프라인의 병목은 추론입니다. 추론 시간은 모델을 처음 불러와 데우는 시간이 섞이느냐에 따라 크게 달라집니다(교안 PC 에서 앞 실습을 돌린 뒤에는 약 1.7초, 프로젝트만 처음 돌리면 약 7.4초). 숫자는 컴퓨터와 실행마다 다르지만, 추론이 가장 오래 걸린다는 순서는 바뀌지 않습니다.